Agent 相关知识学习
这边列举的是学习的马克的技术工坊的相关内容!笔记也是按照其时间排列进行的,由于时间跨度较大,所以可能会出现一些「知识点冲突的情况」,到时候稍微说明一下即可
Context Engineering
上下文经常会遇到的问题:
- LLM 的上下文窗口大小非常有限
- 输入杂乱会影响 LLM 理解
- 输入越多,成本越高
上下文工程也就是为了怎么精心的给 LLM 的输入内容让他在上下文窗口内理解的尽可能的准确
大概划分为四类:
- 保存上下文
通过筛选/总结将文本存入到内存/硬盘中去,当然,这里存放的内容多了,如何选择到有效的信息也就成为了一个问题 - 选择上下文
分为静态选择和动态选择
静态选择:将一些永远重要,必须遵循的东西全部放进去,之后每次请求都会全部放到 context 中,比如某些 IDE 里面的 rules 或者 CLAUDE.md 这个文件
动态选择:选择与用户问题最为相关的内容放入上下文:比如 chatgpt 挑选记忆,挑选使用哪个工具
动态选择实现方式最常见的就是 RAG*
- 压缩上下文
对于上下文中最占空间的是:工具执行结果,LLM 输出结果
如果不及时处理,上下文很快会被挤占满
所以需要将上下文进行压缩,比如 claude/codex 在快将上下文占满的时候就会开始压缩,claude code 还可以指定重点内容进行压缩(当然,压缩就相对简单了,直接总结一下即可)
- 隔离上下文
常见于 multi-Agent 系统中
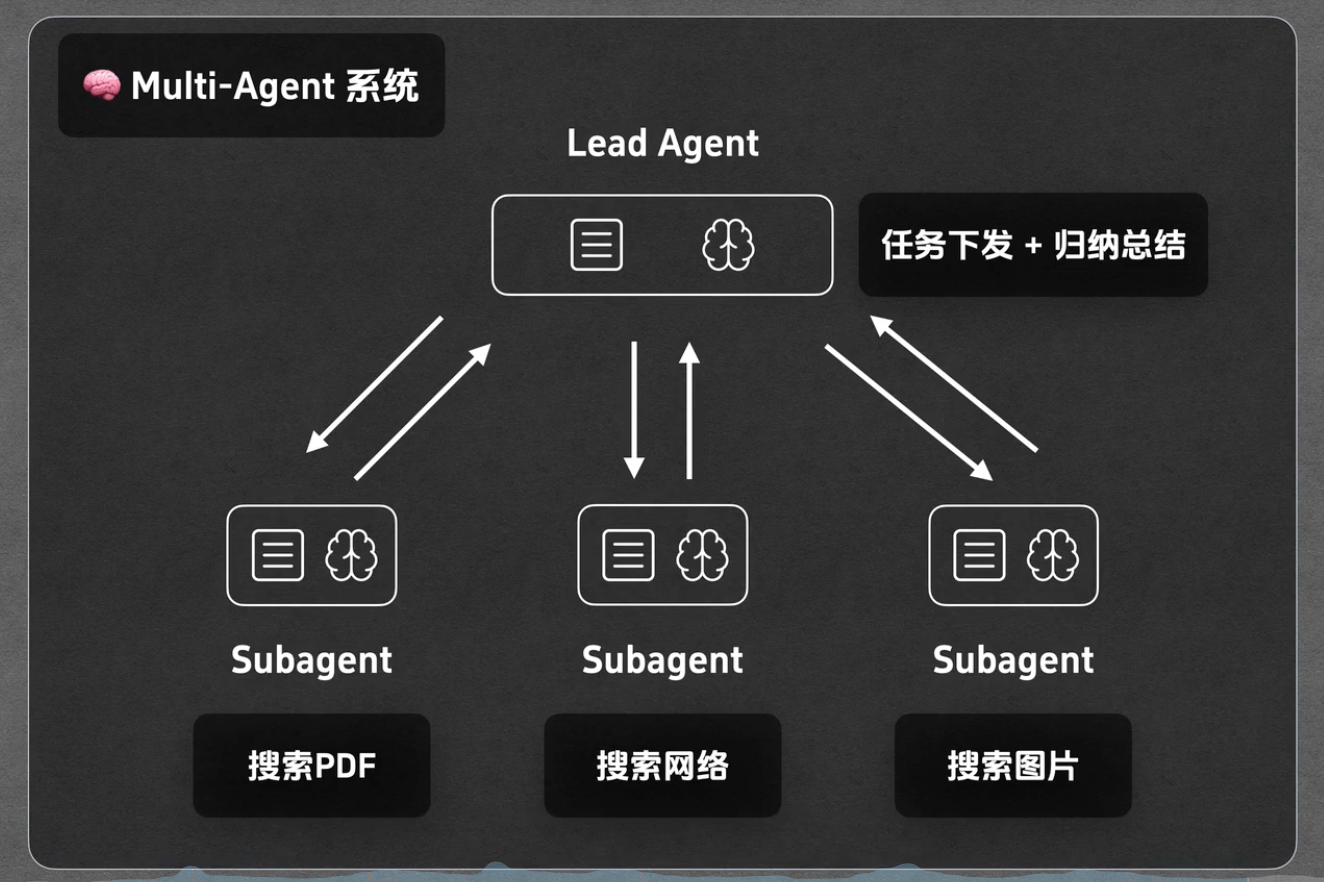
每个 subAgent 都有着自己的独立记忆体系,工具,历史,互相隔离,不受影响
btw,东西有点少啊,我感觉没学到什么东西呀...感觉只是在科普,后面还需要学习更多的东西
temperature&top-p
这两个参数越高越随机,越有创造力,越低则越保守,确定,但是为什么呢?又为什么需要两个参数?到底是怎么影响的呢?
一点点原理:
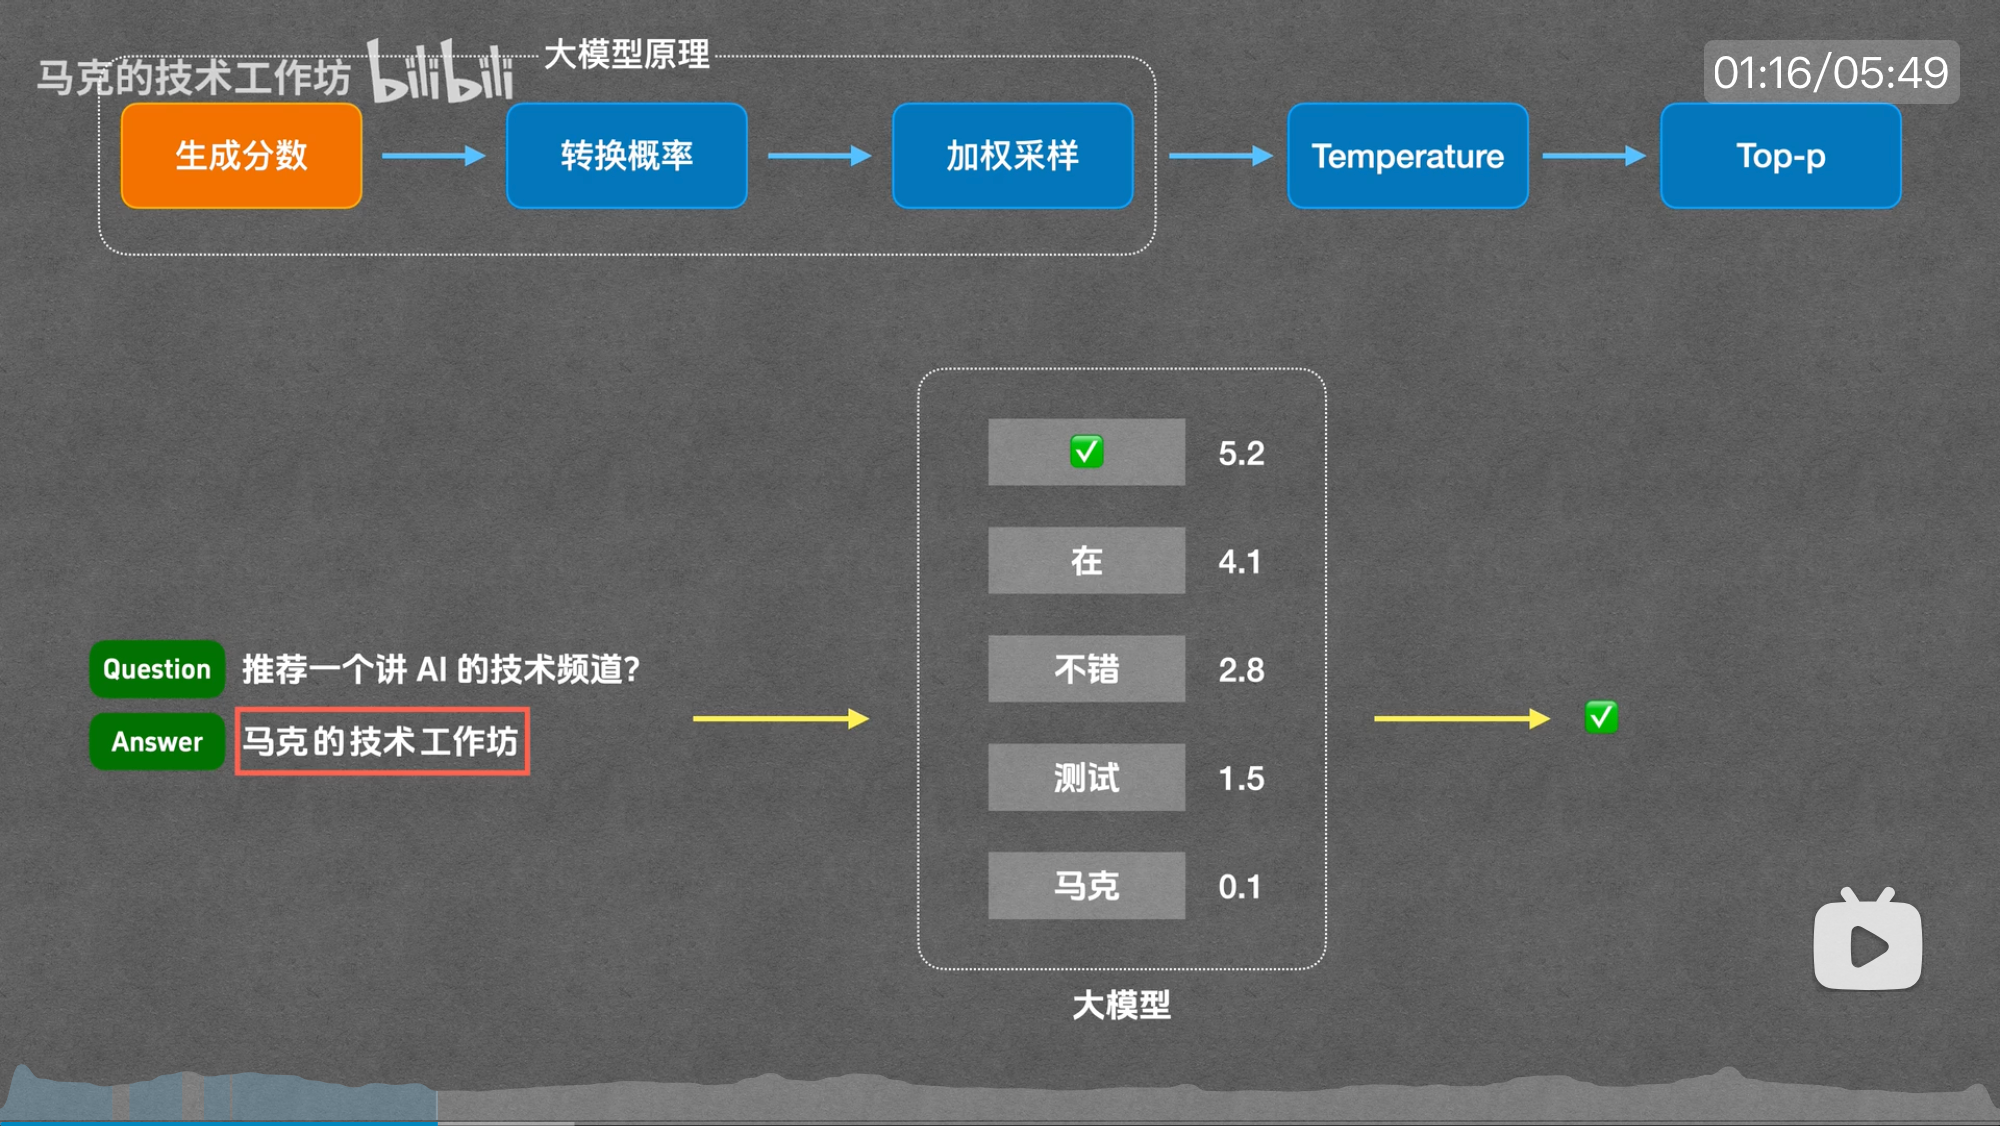
这里只选择最高分的话,其他的东西就没有机会了
需要转换为概率!
那么:
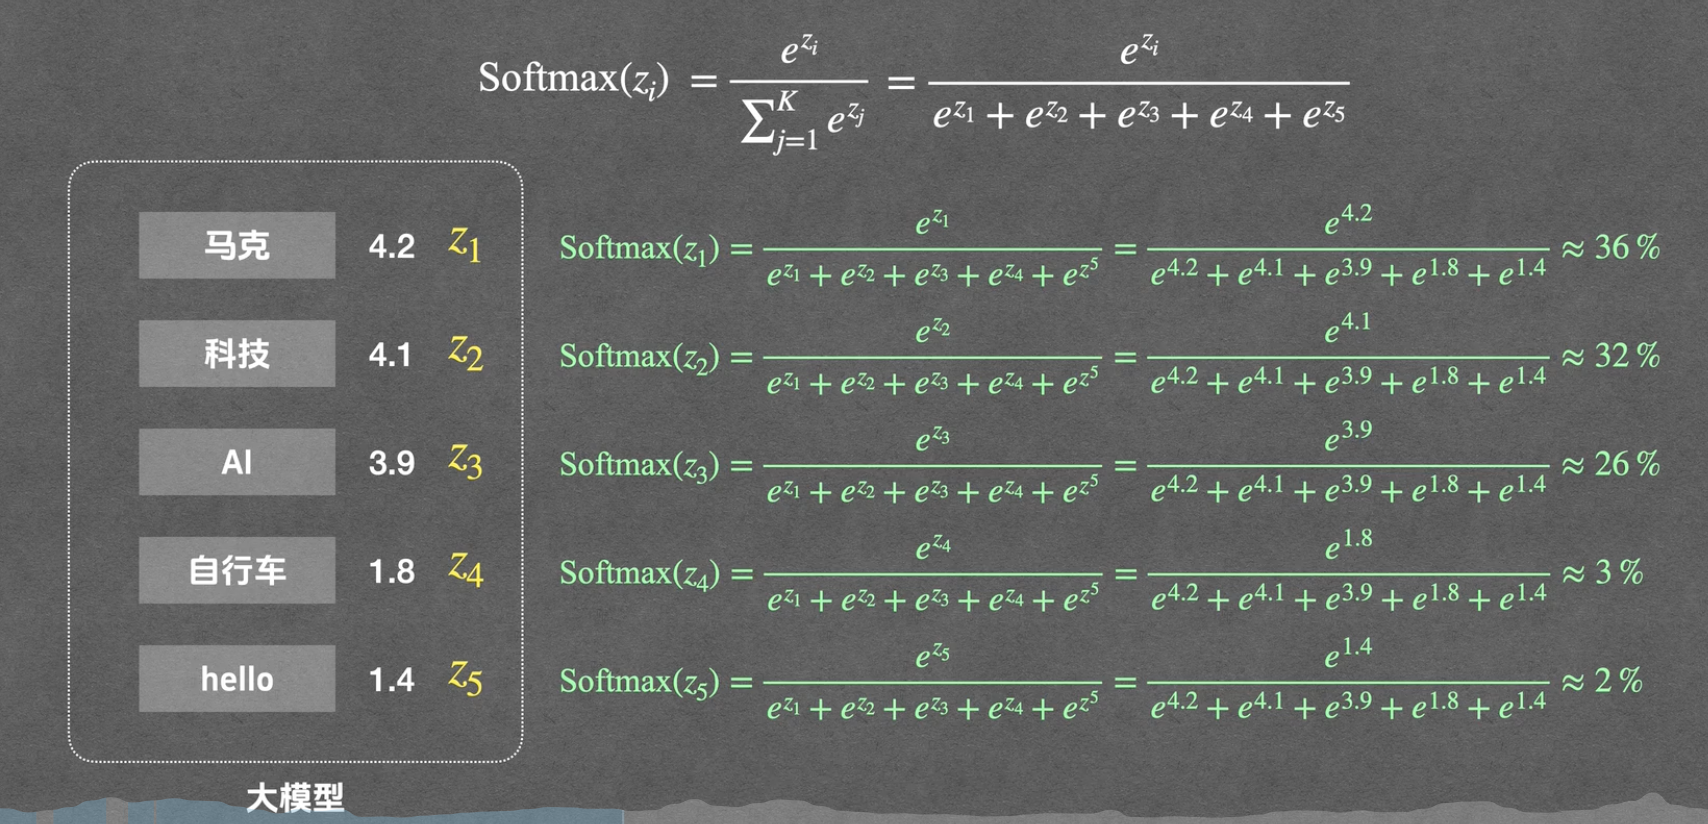
现在则是从
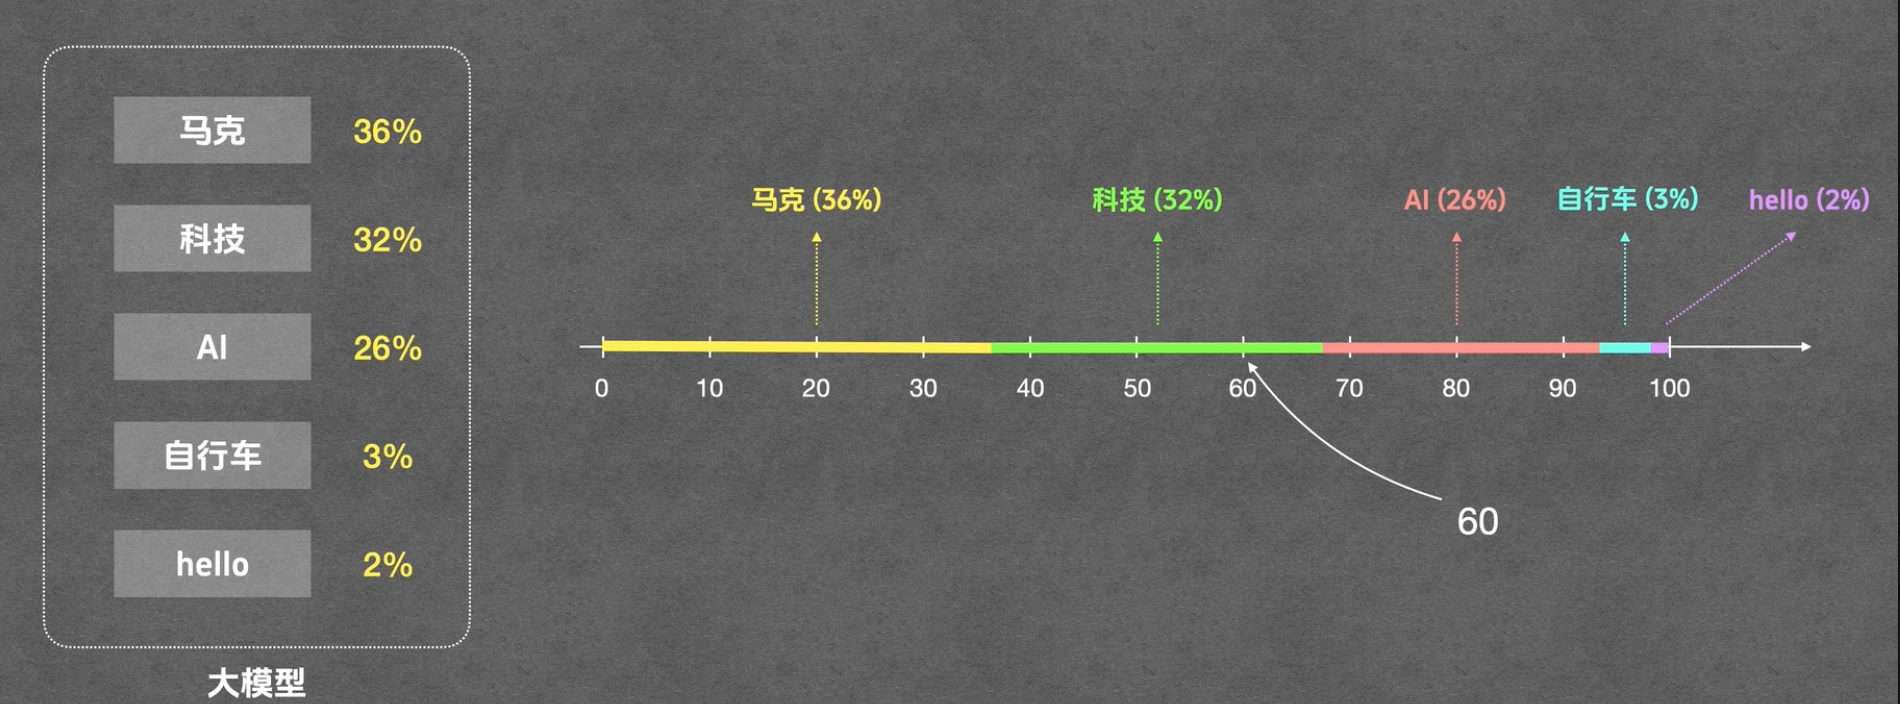
那么这两个参数体现在?
这个函数得加个参数,默认 T=1 才是上面那个
这里 T(温度) 会改变不同词的概率差距:
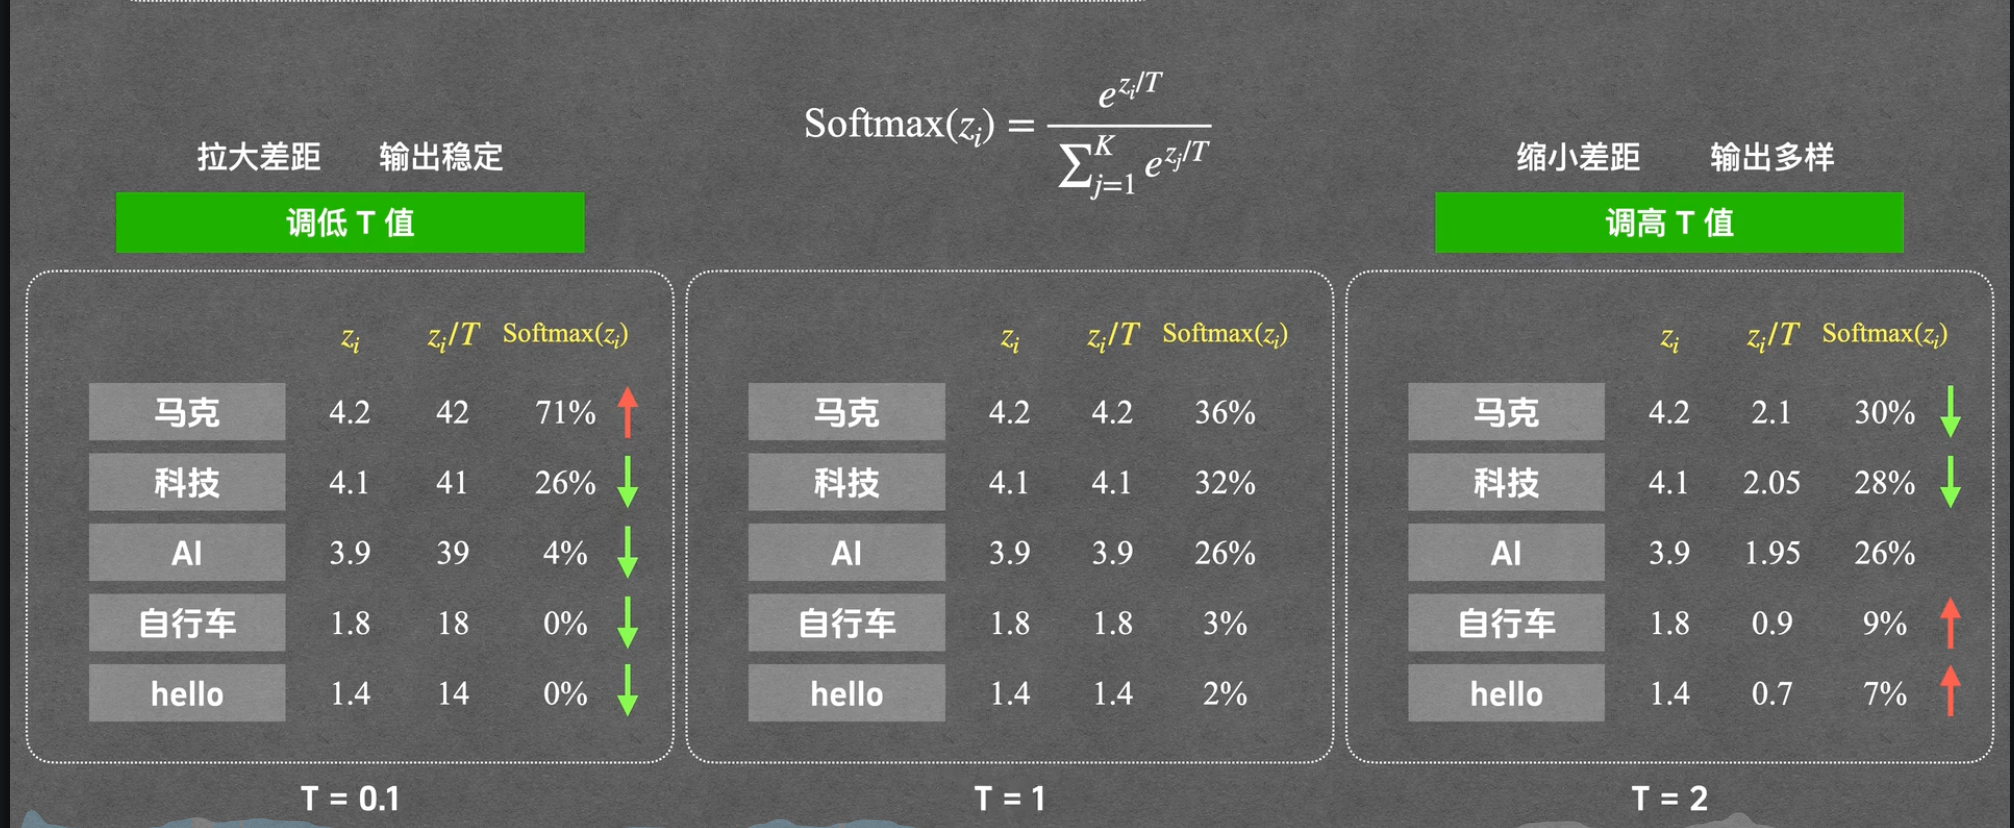
top-p(最高累加概率) 有什么用?
对于上面看到的那个数轴而言,可以看到,会有小概率的情况我们会选择到一些非常莫名其妙的词,比如自行车,我们是需要避免这样的情况出现的,这种词被称为长尾词
top-p 相当于一个阈值,达到了这个阈值的概率之后,后面的东西则不再保留,若 top-p=0.9,则数轴从 90 开始截断了,自行车和 hello 没有机会出现了,然后这个数轴又会等比例放大回 100,这样就有效的去除了垃圾词
可以理解为一个入门门槛
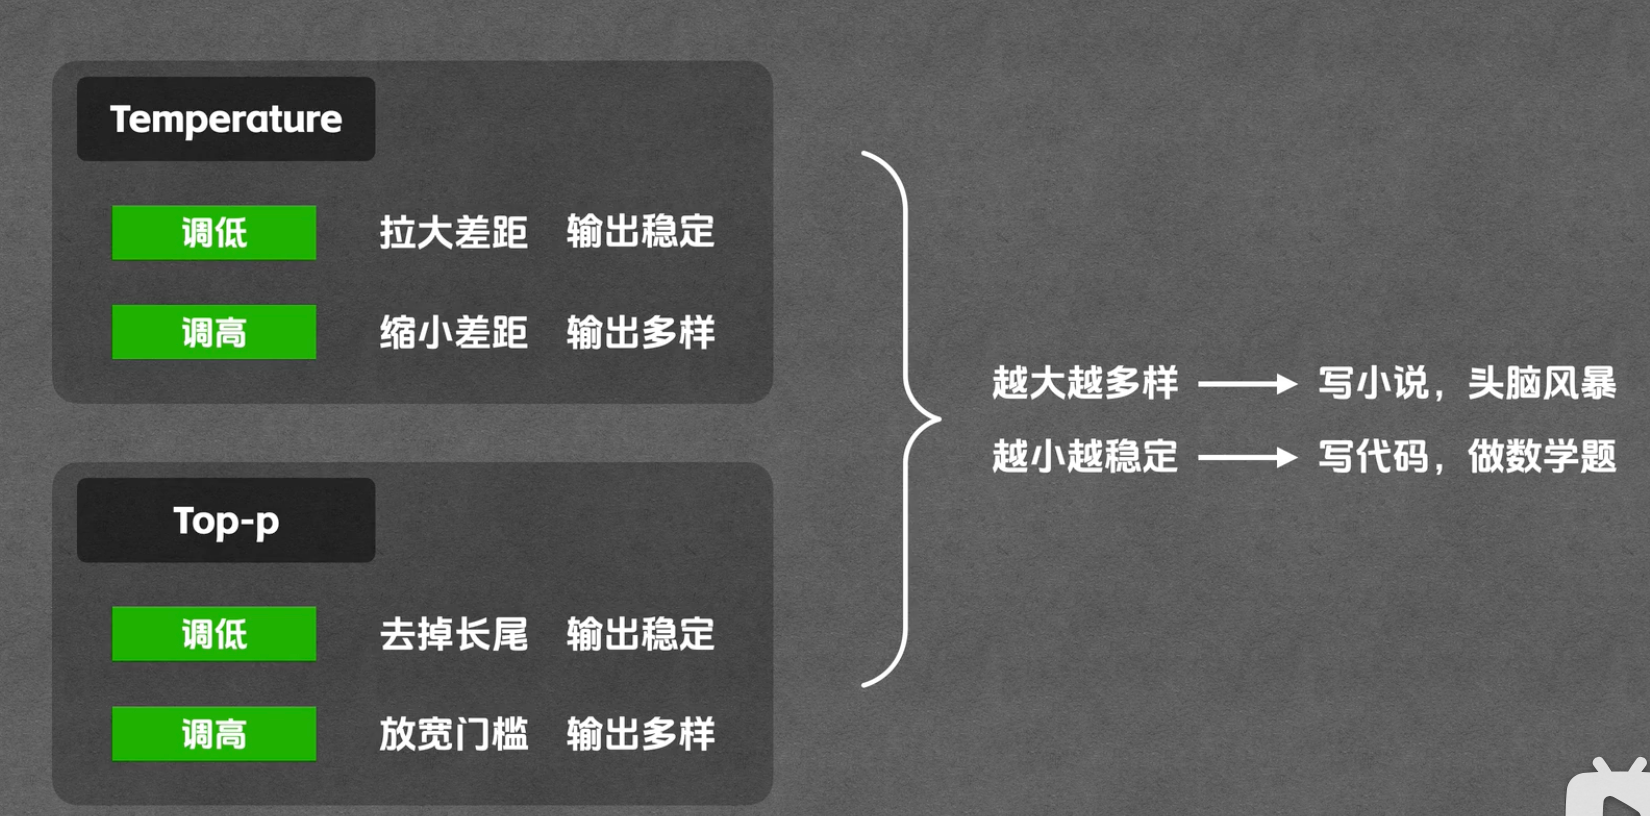
小结:
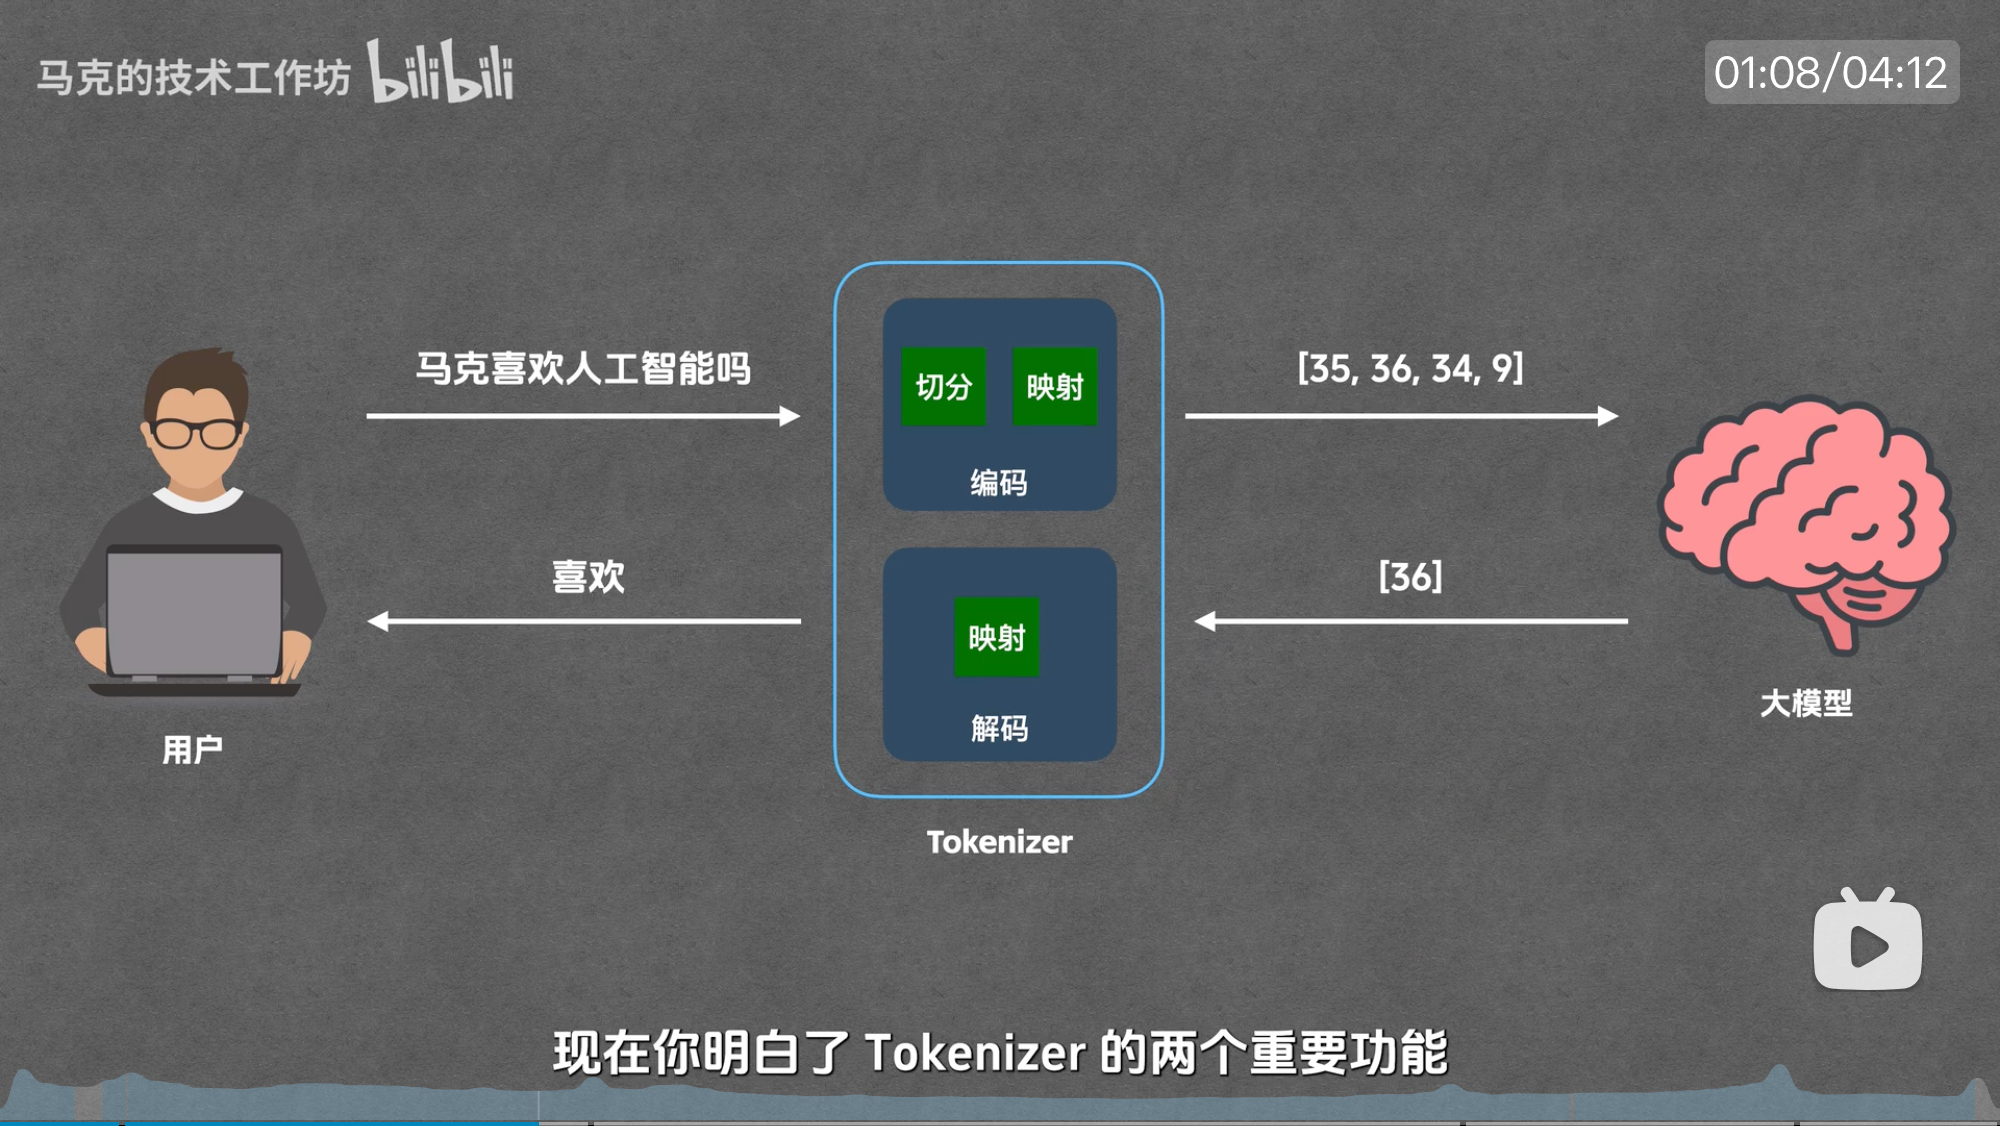
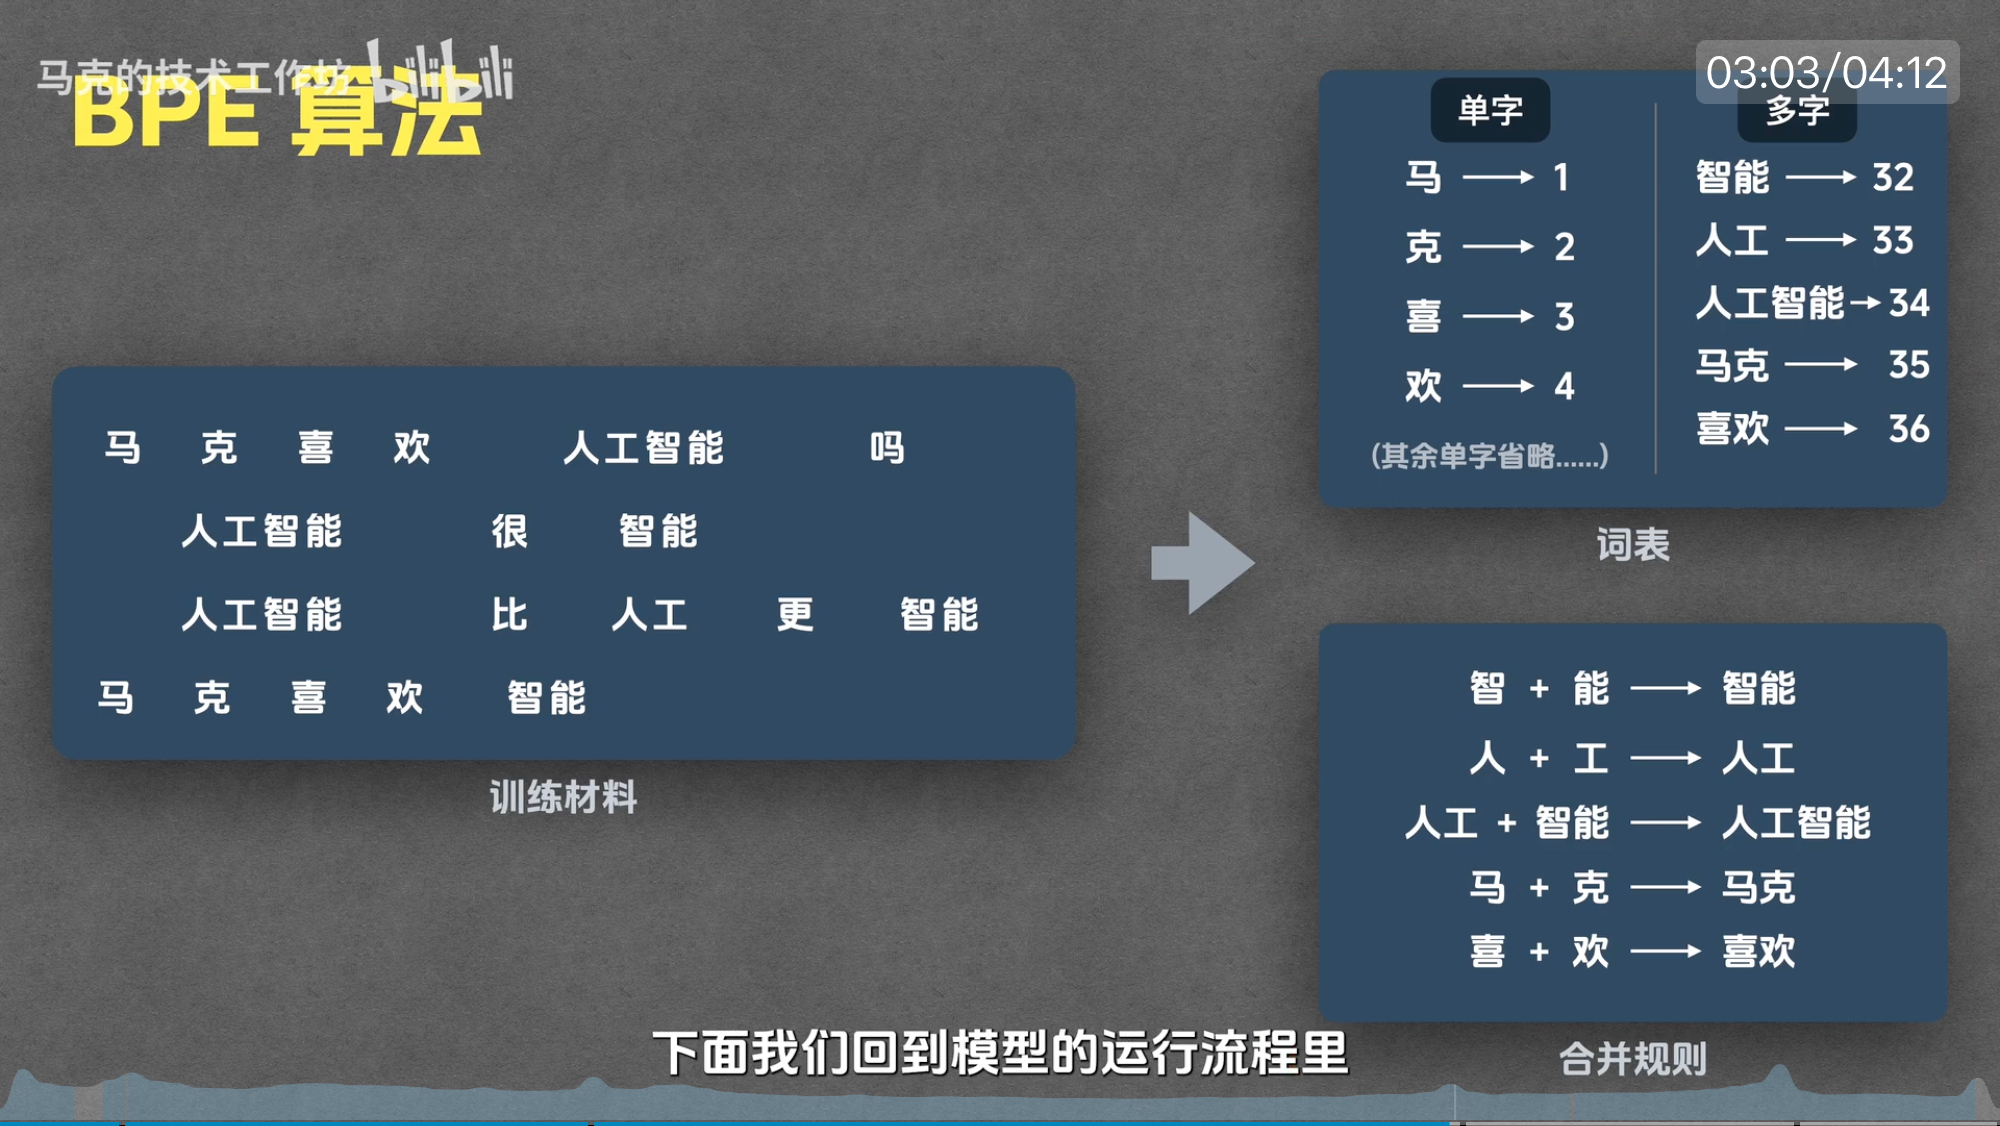
Token 生成机制
Skills
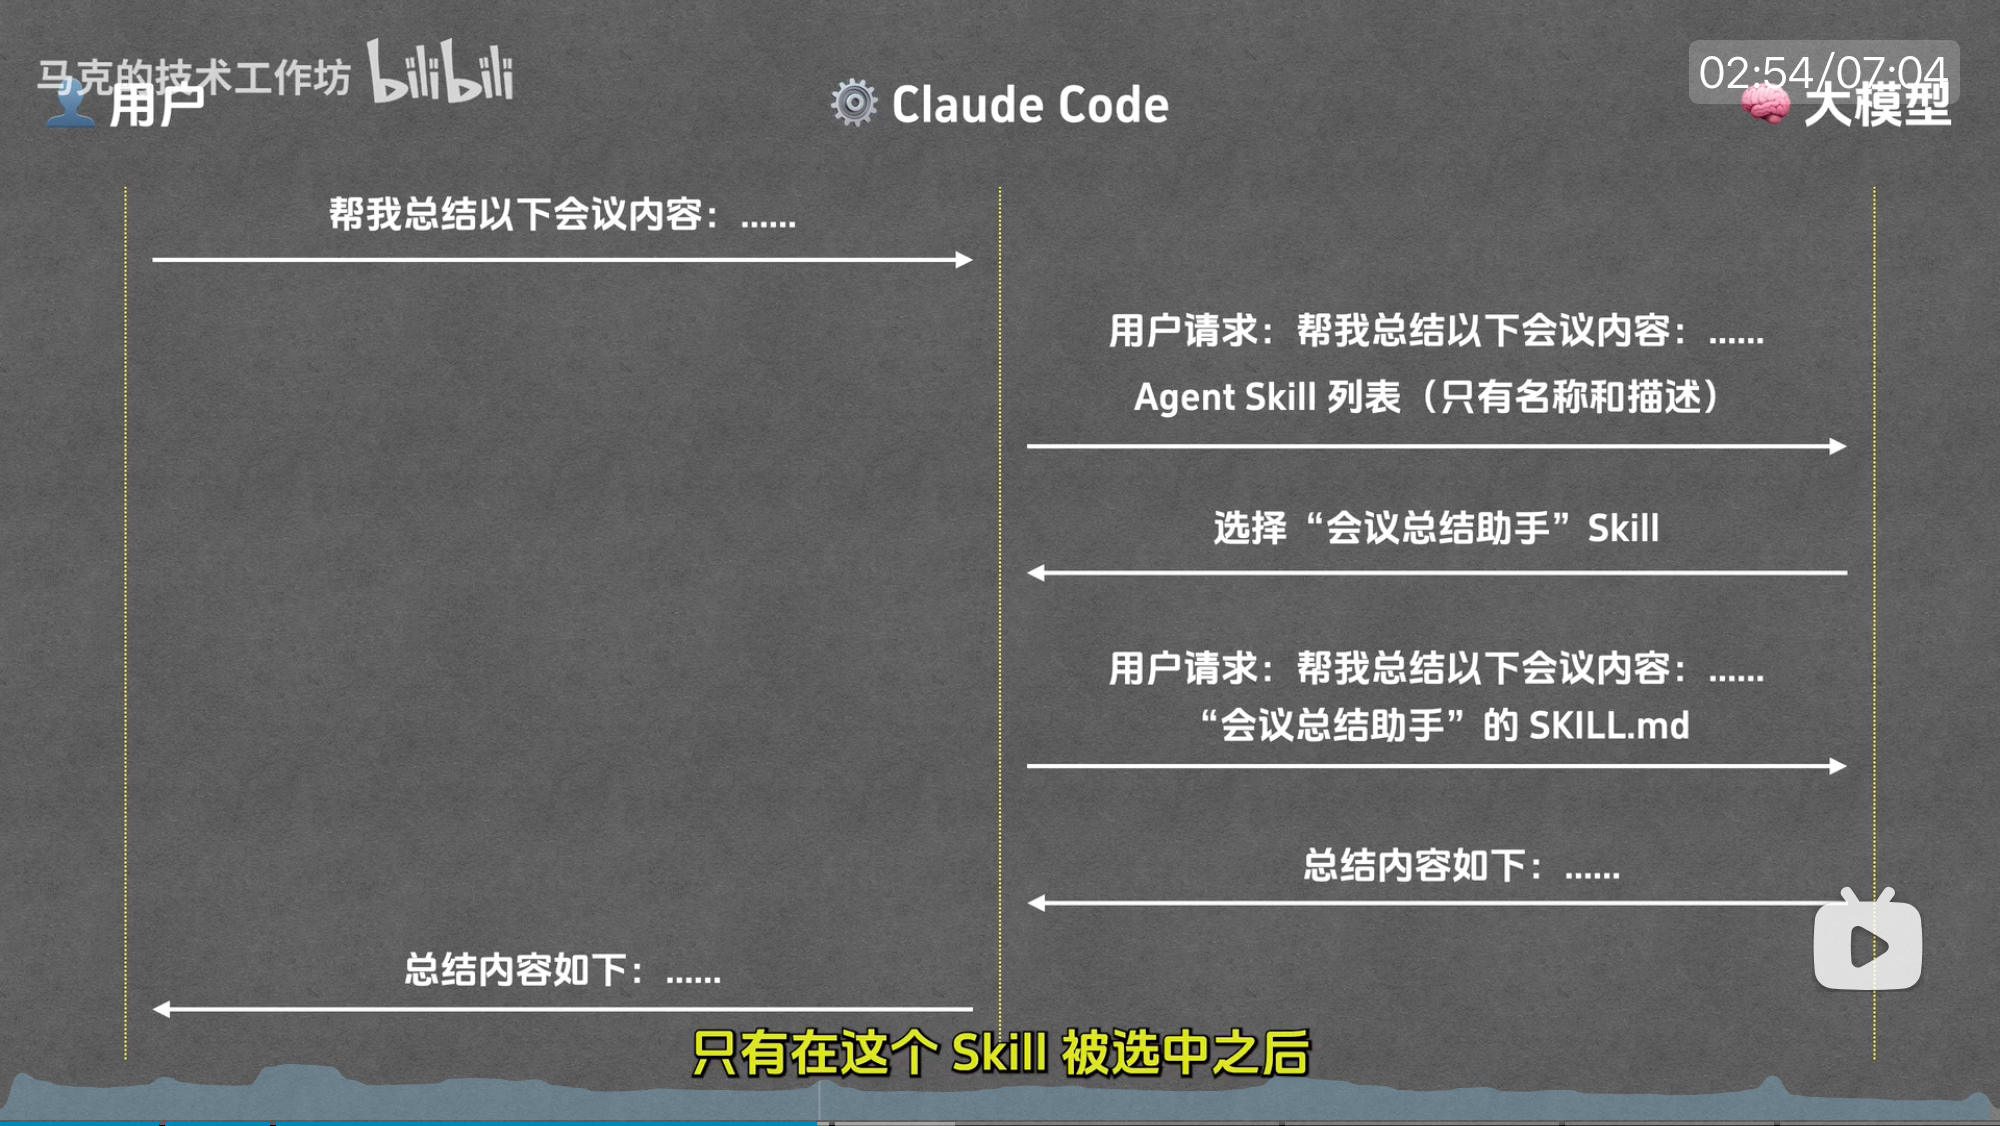
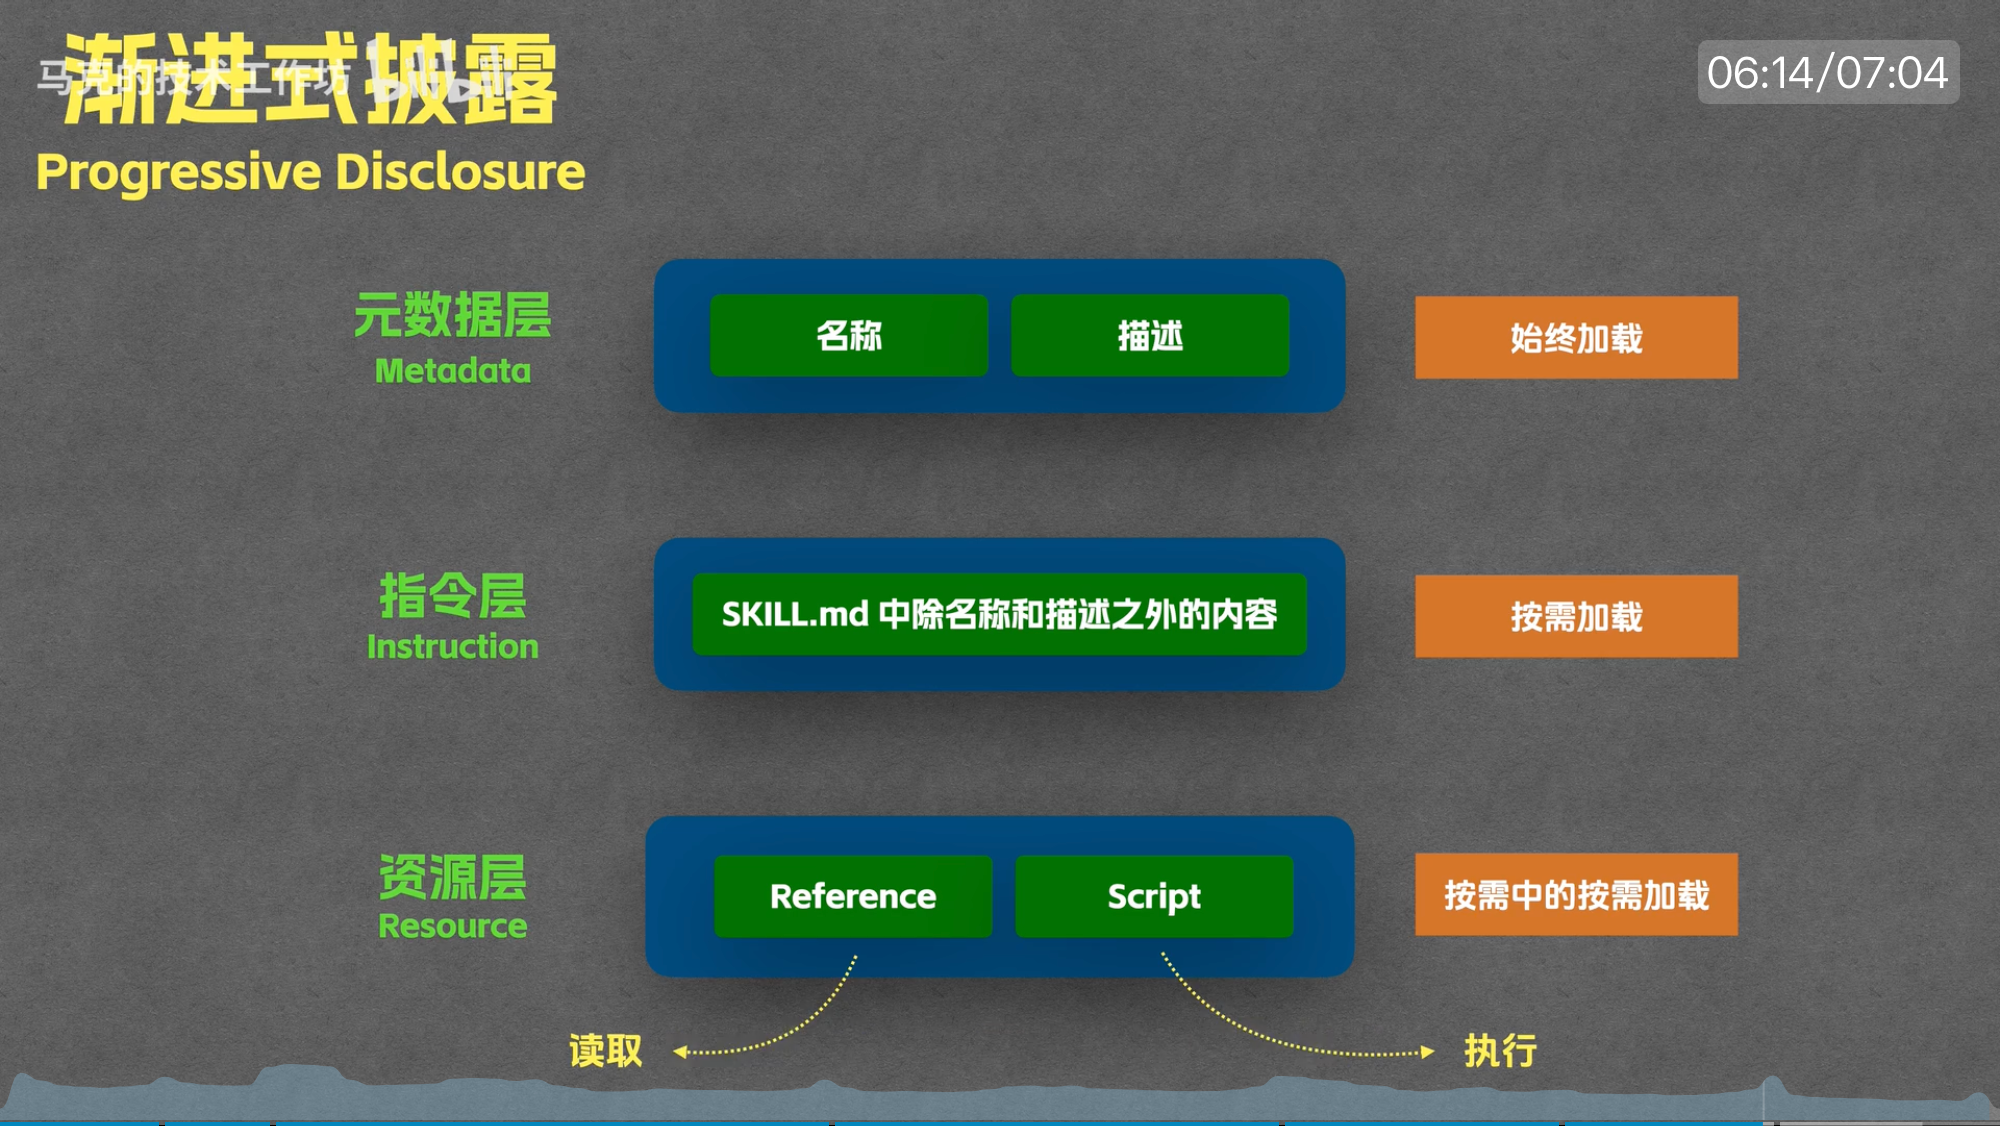
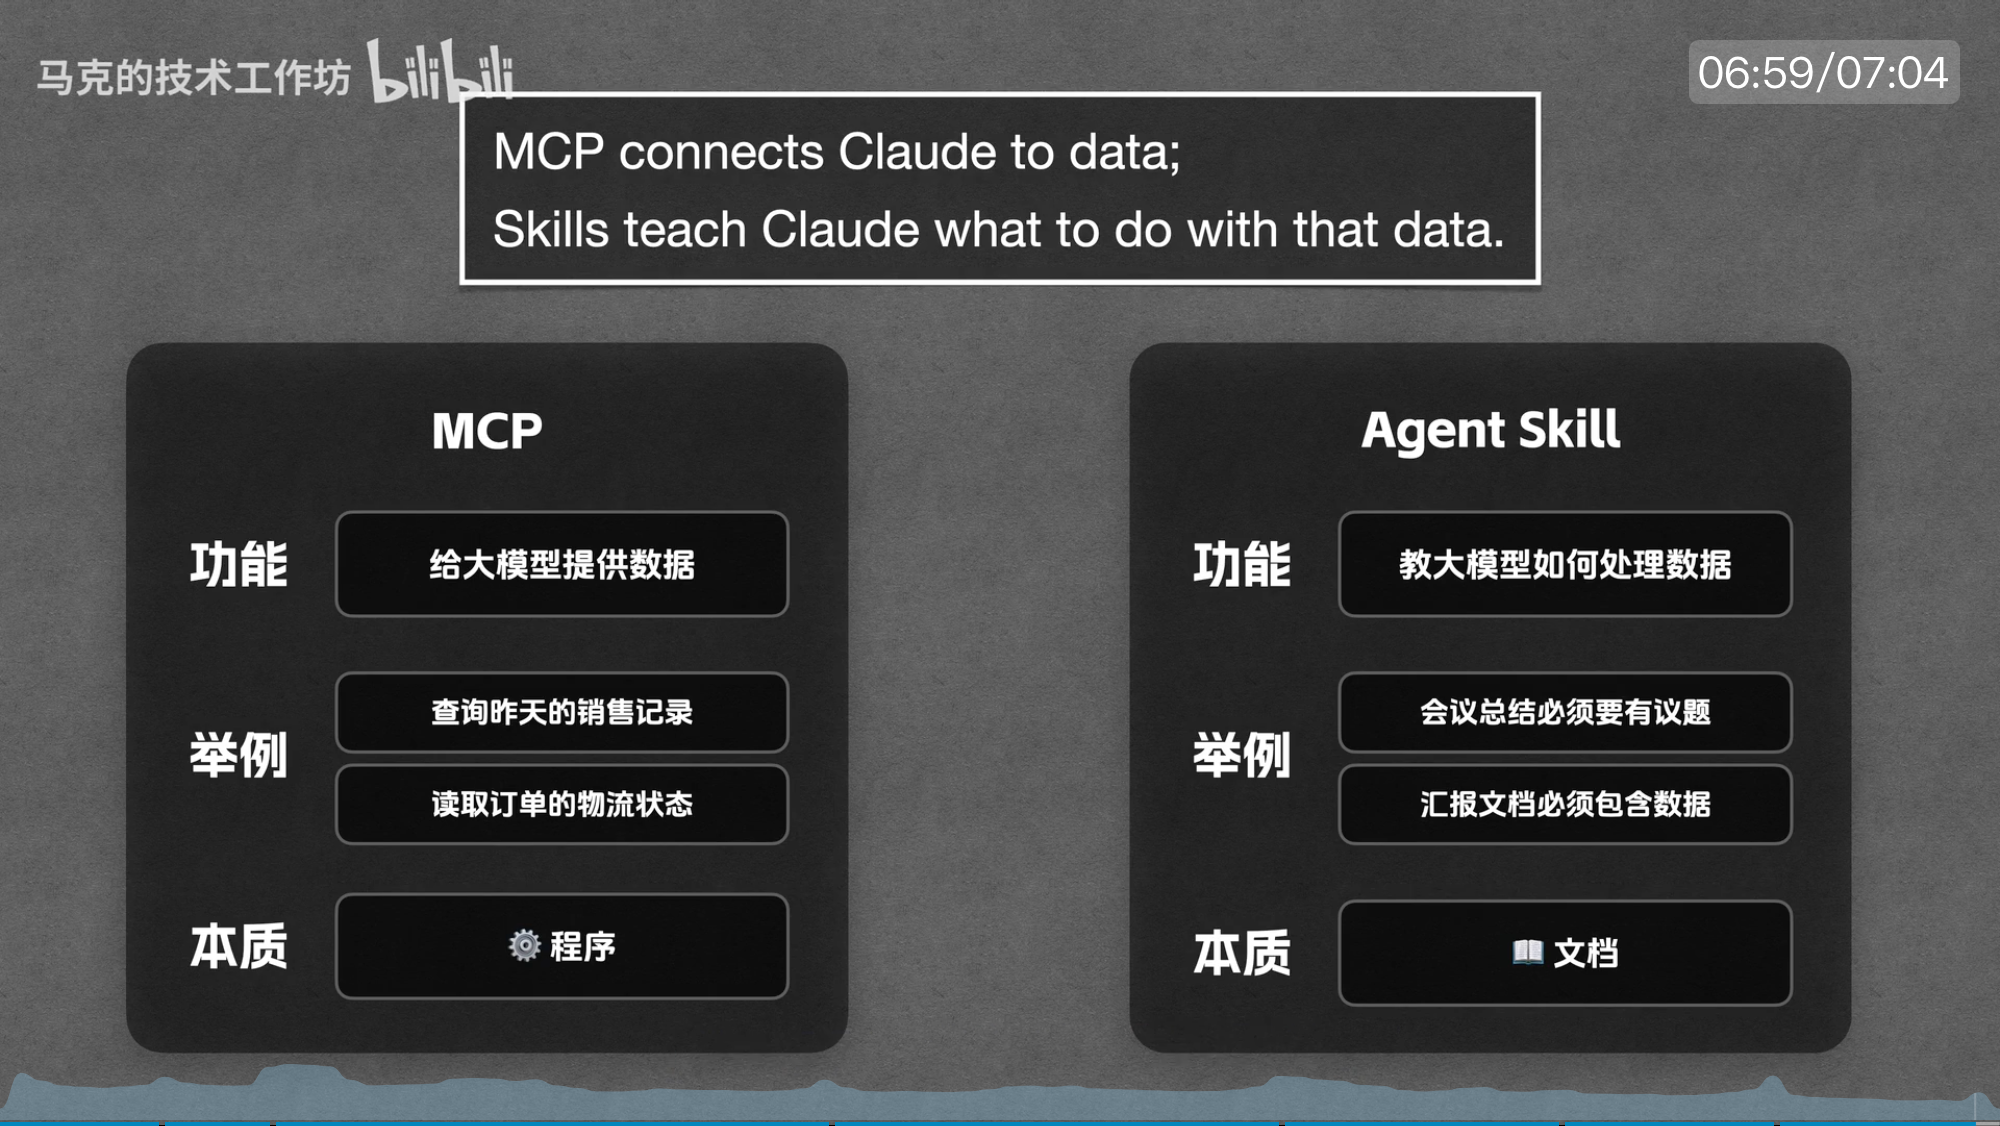
claude code 使用
Claude Code 从 0 到 1 全攻略:MCP / SubAgent / Agent Ski...
最好的教程!!!非常有用,学到了很多!即使用了很久还是很多不知道
MCP
本身和模型的能力无关
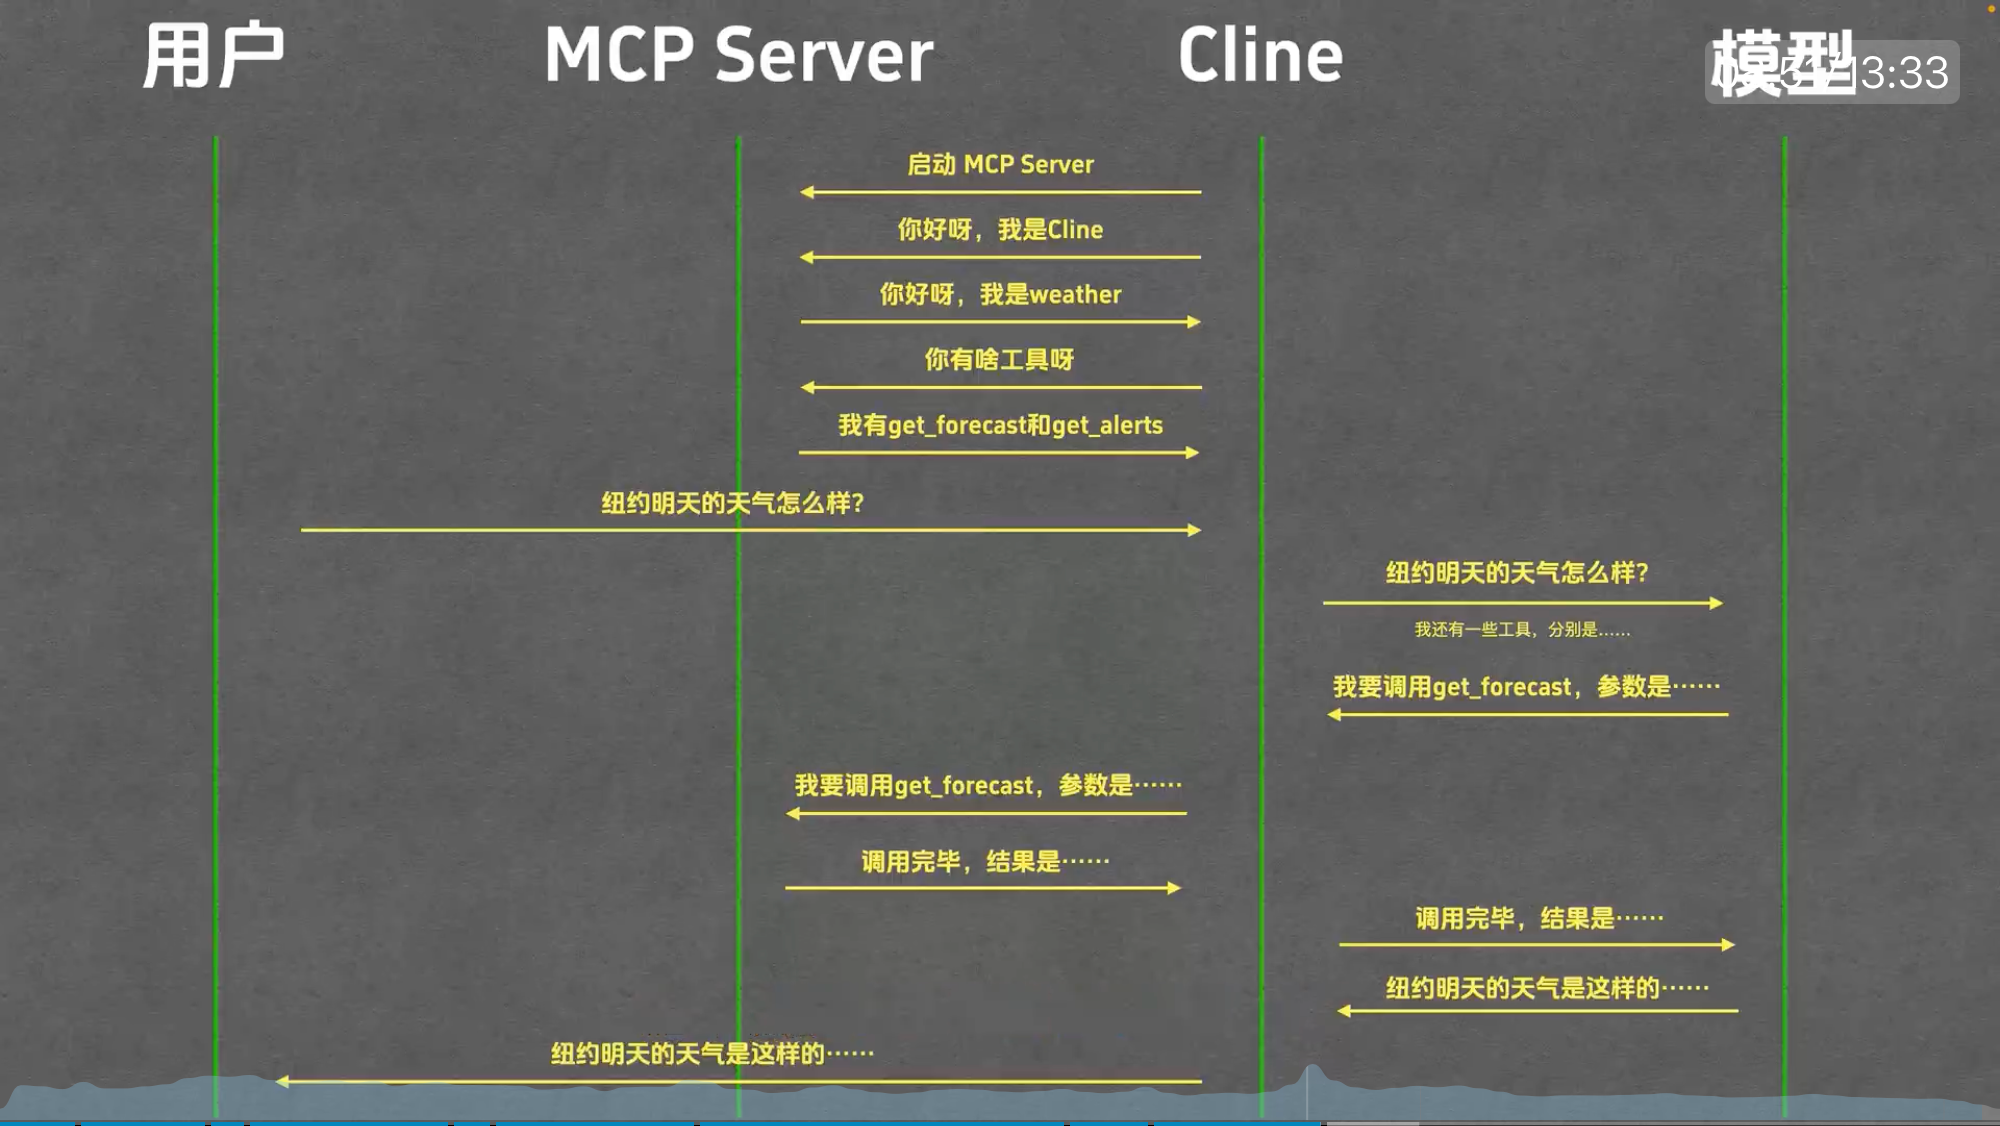
这个部分的质量真的高!!需要做笔记!
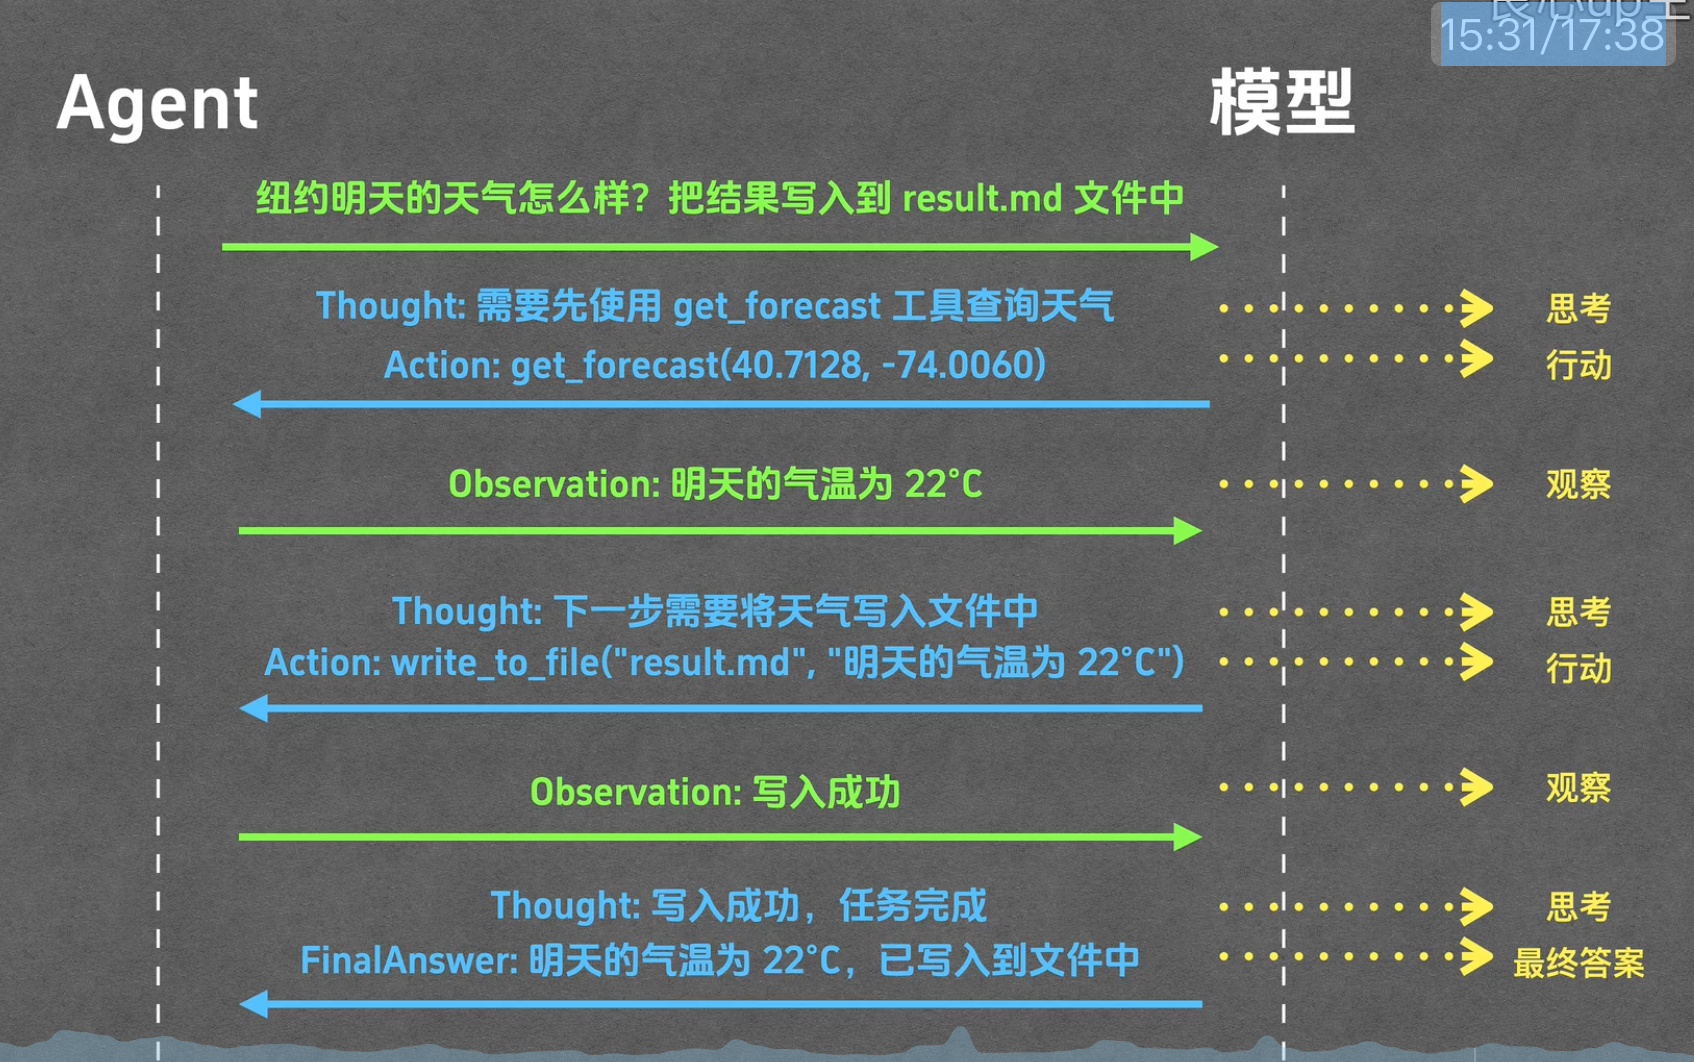
ReAct 模式需要知道
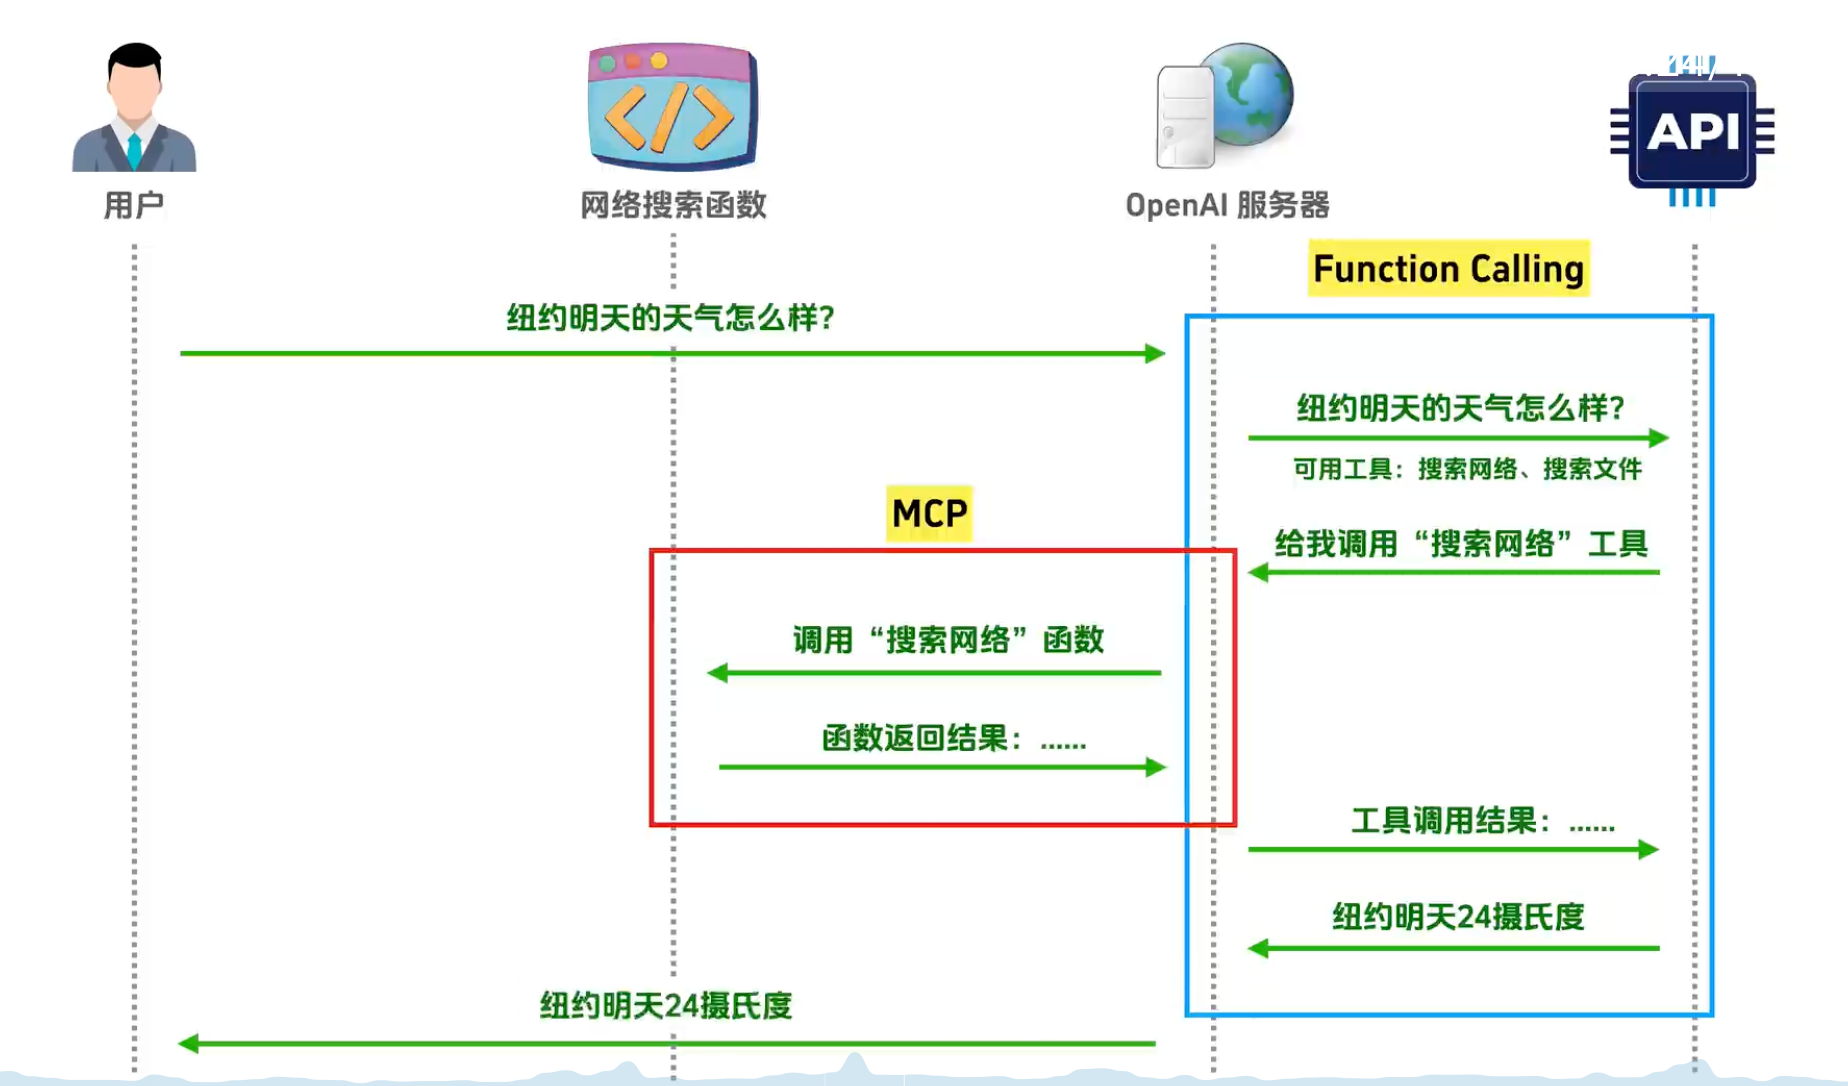
Fuction calling
即模型和外部工具进行交互的能力,即调用工具的能力
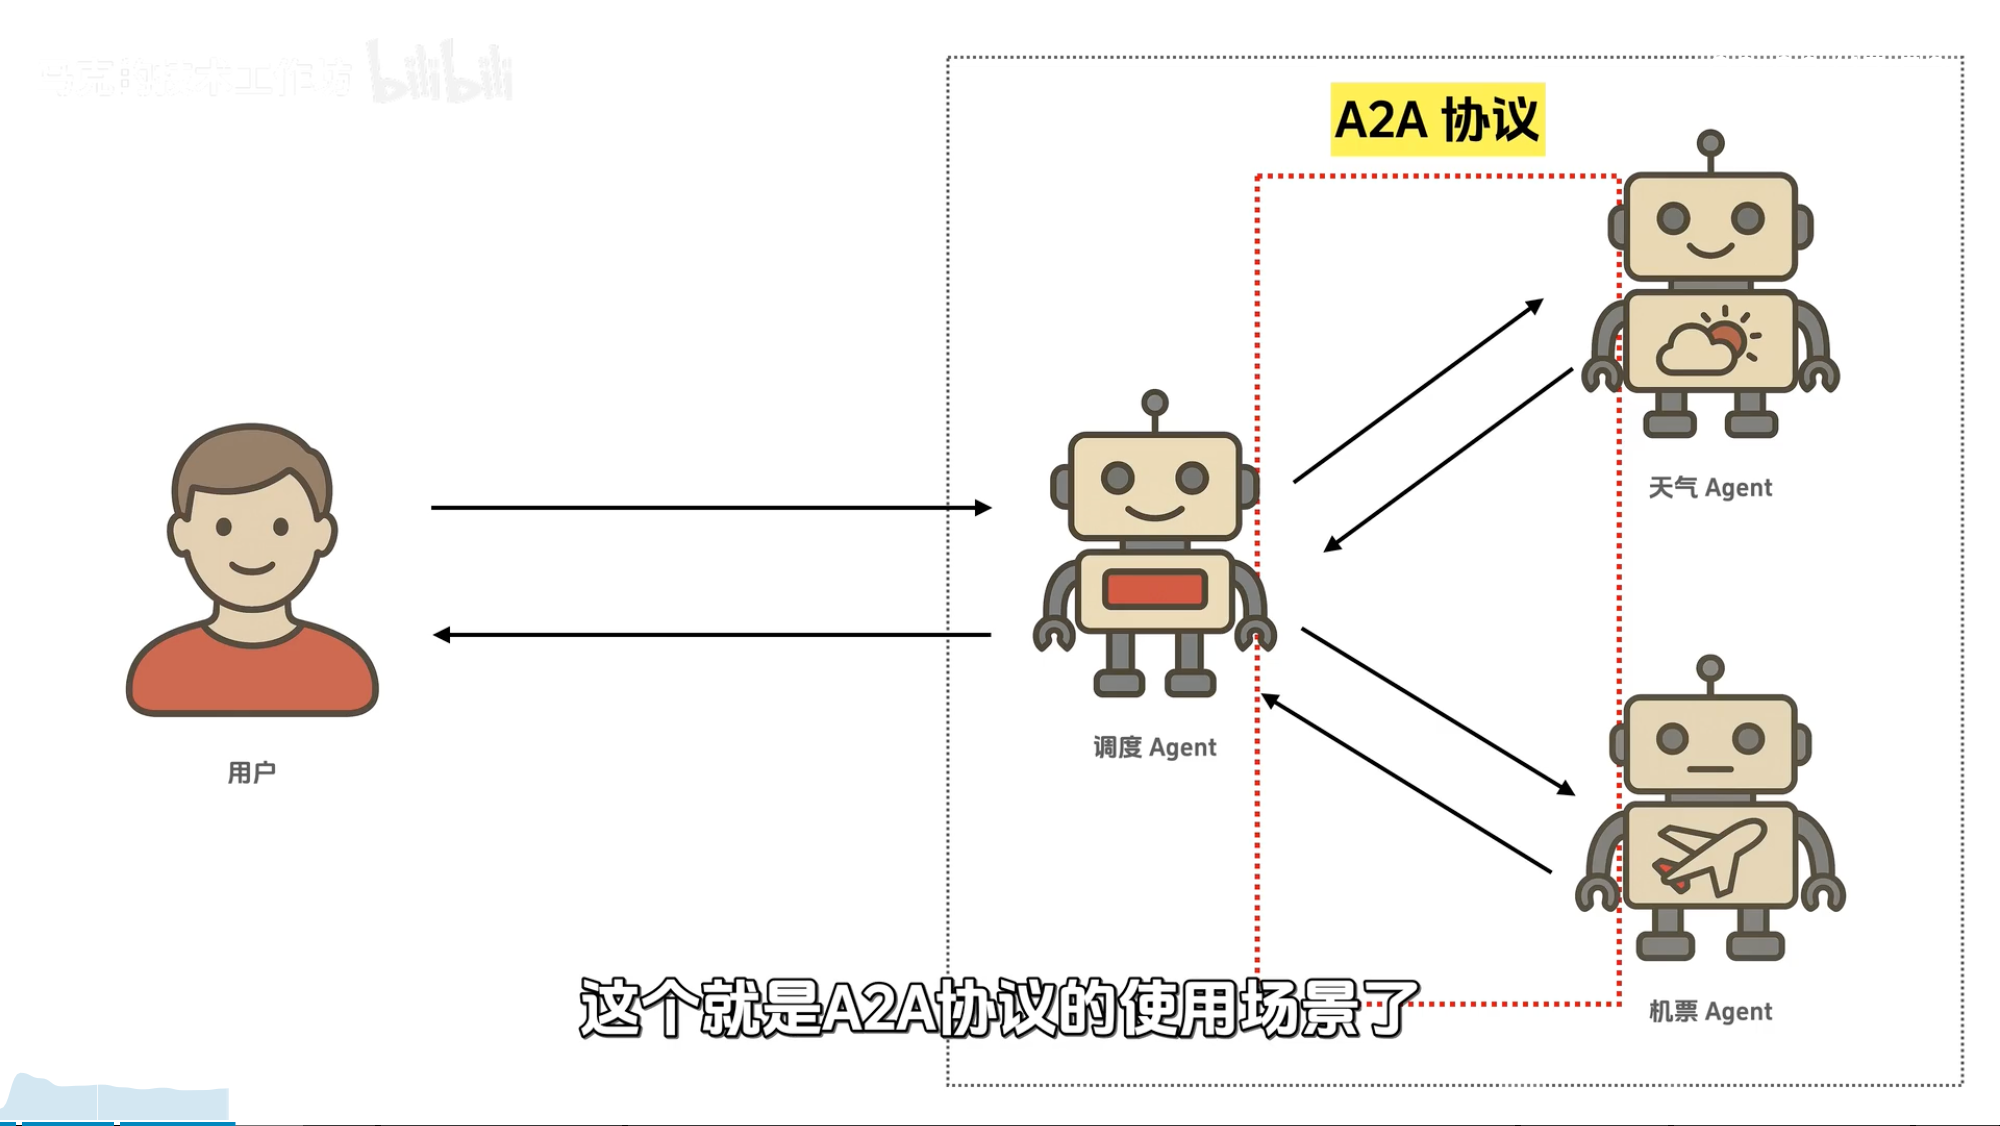
A2A 协议
即 Agent to Agent 协议
作用于 Agent 之间
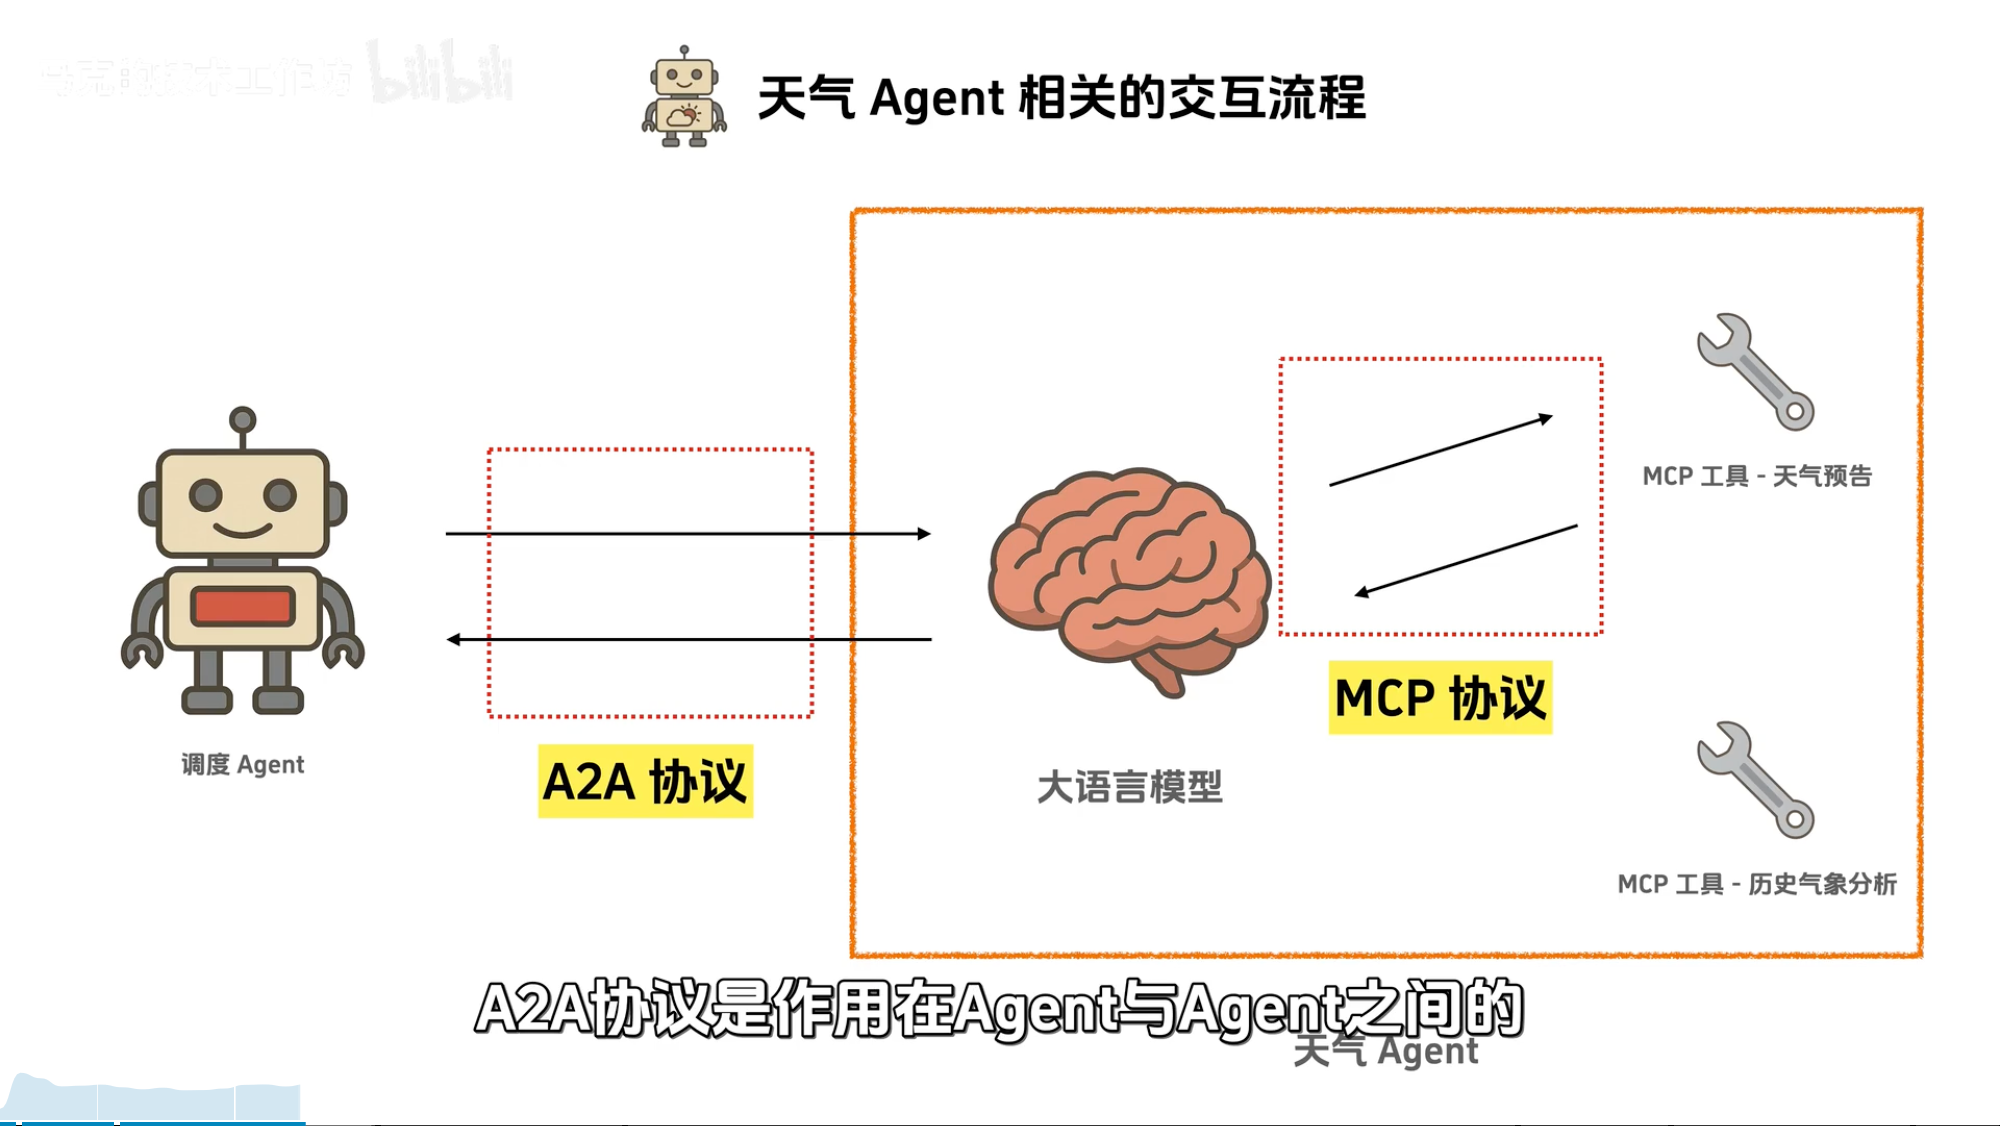
这两个协议的作用域不同
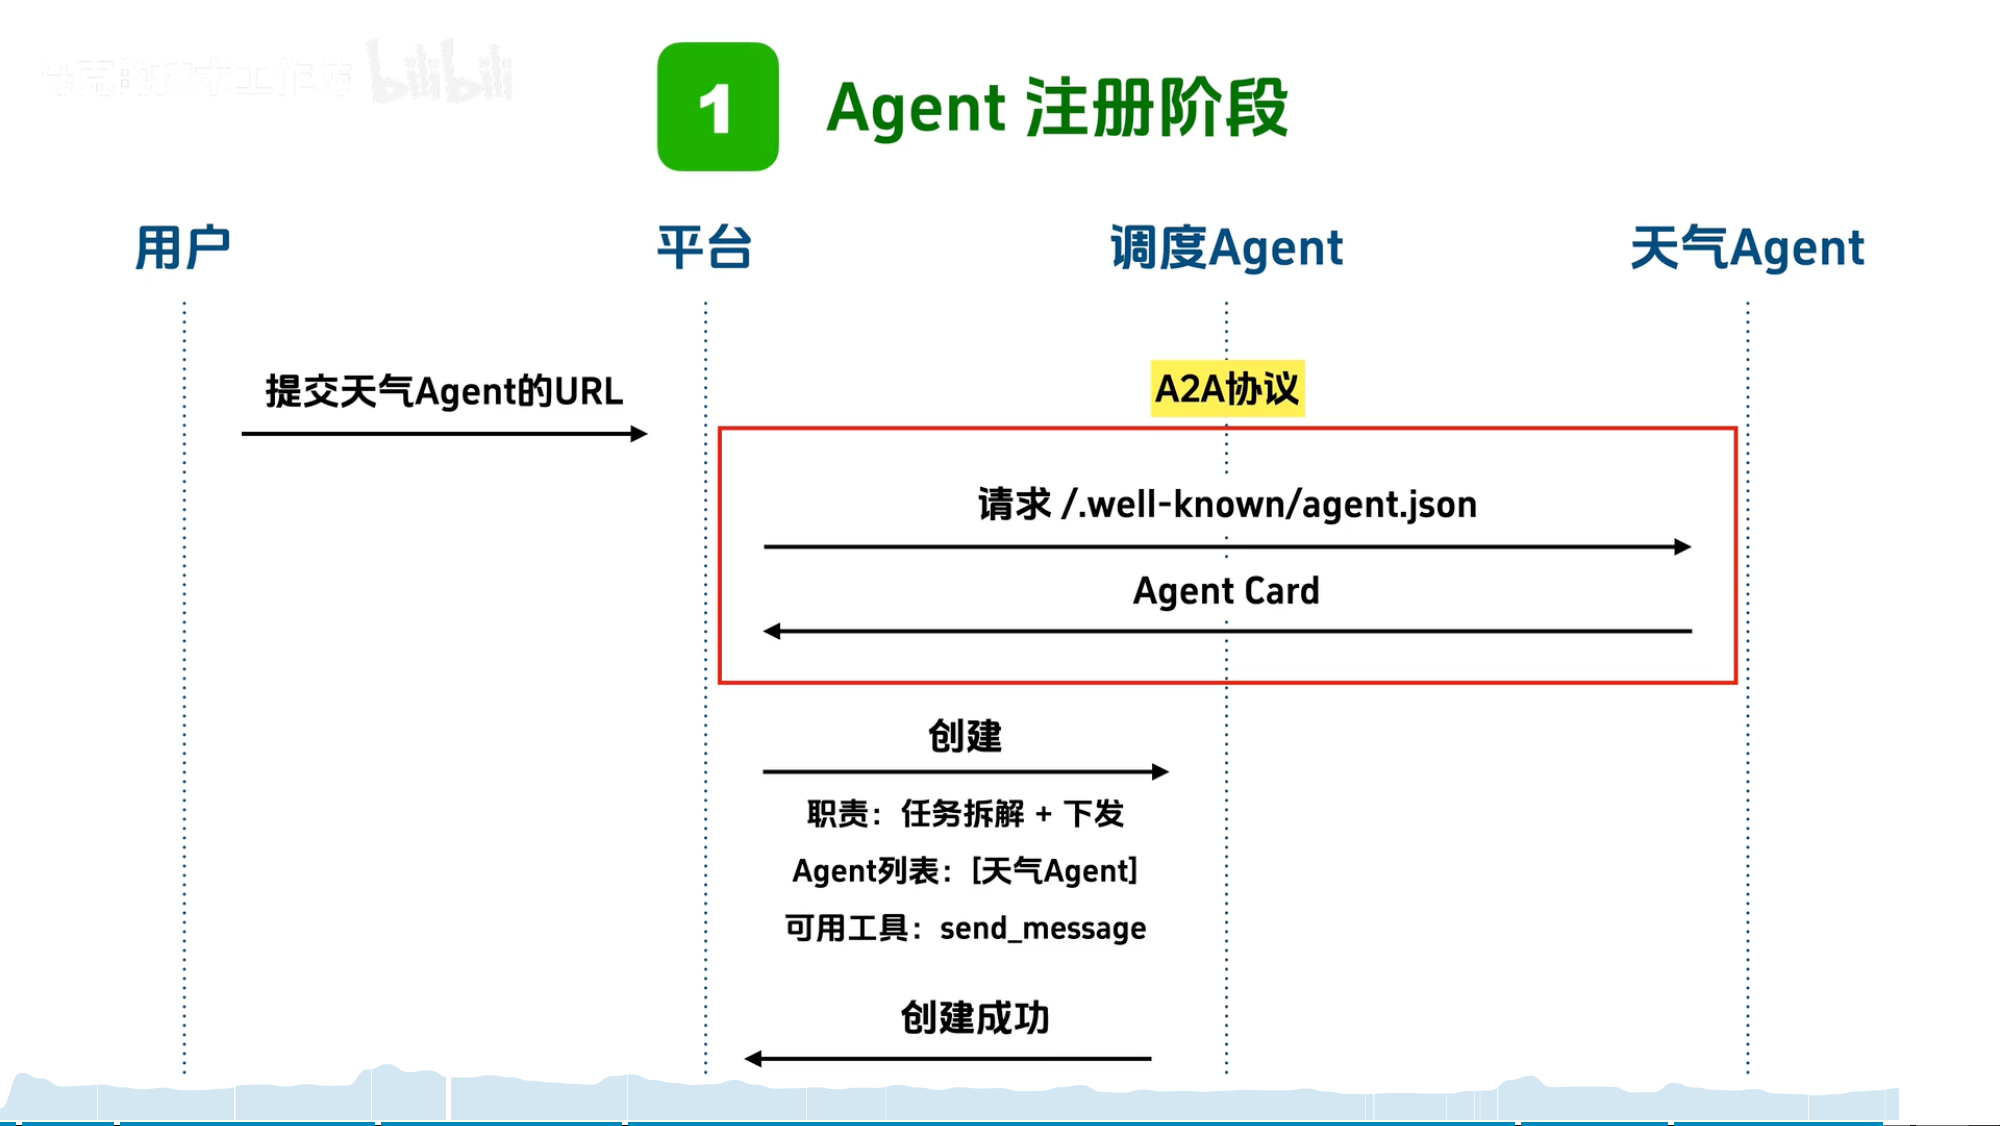
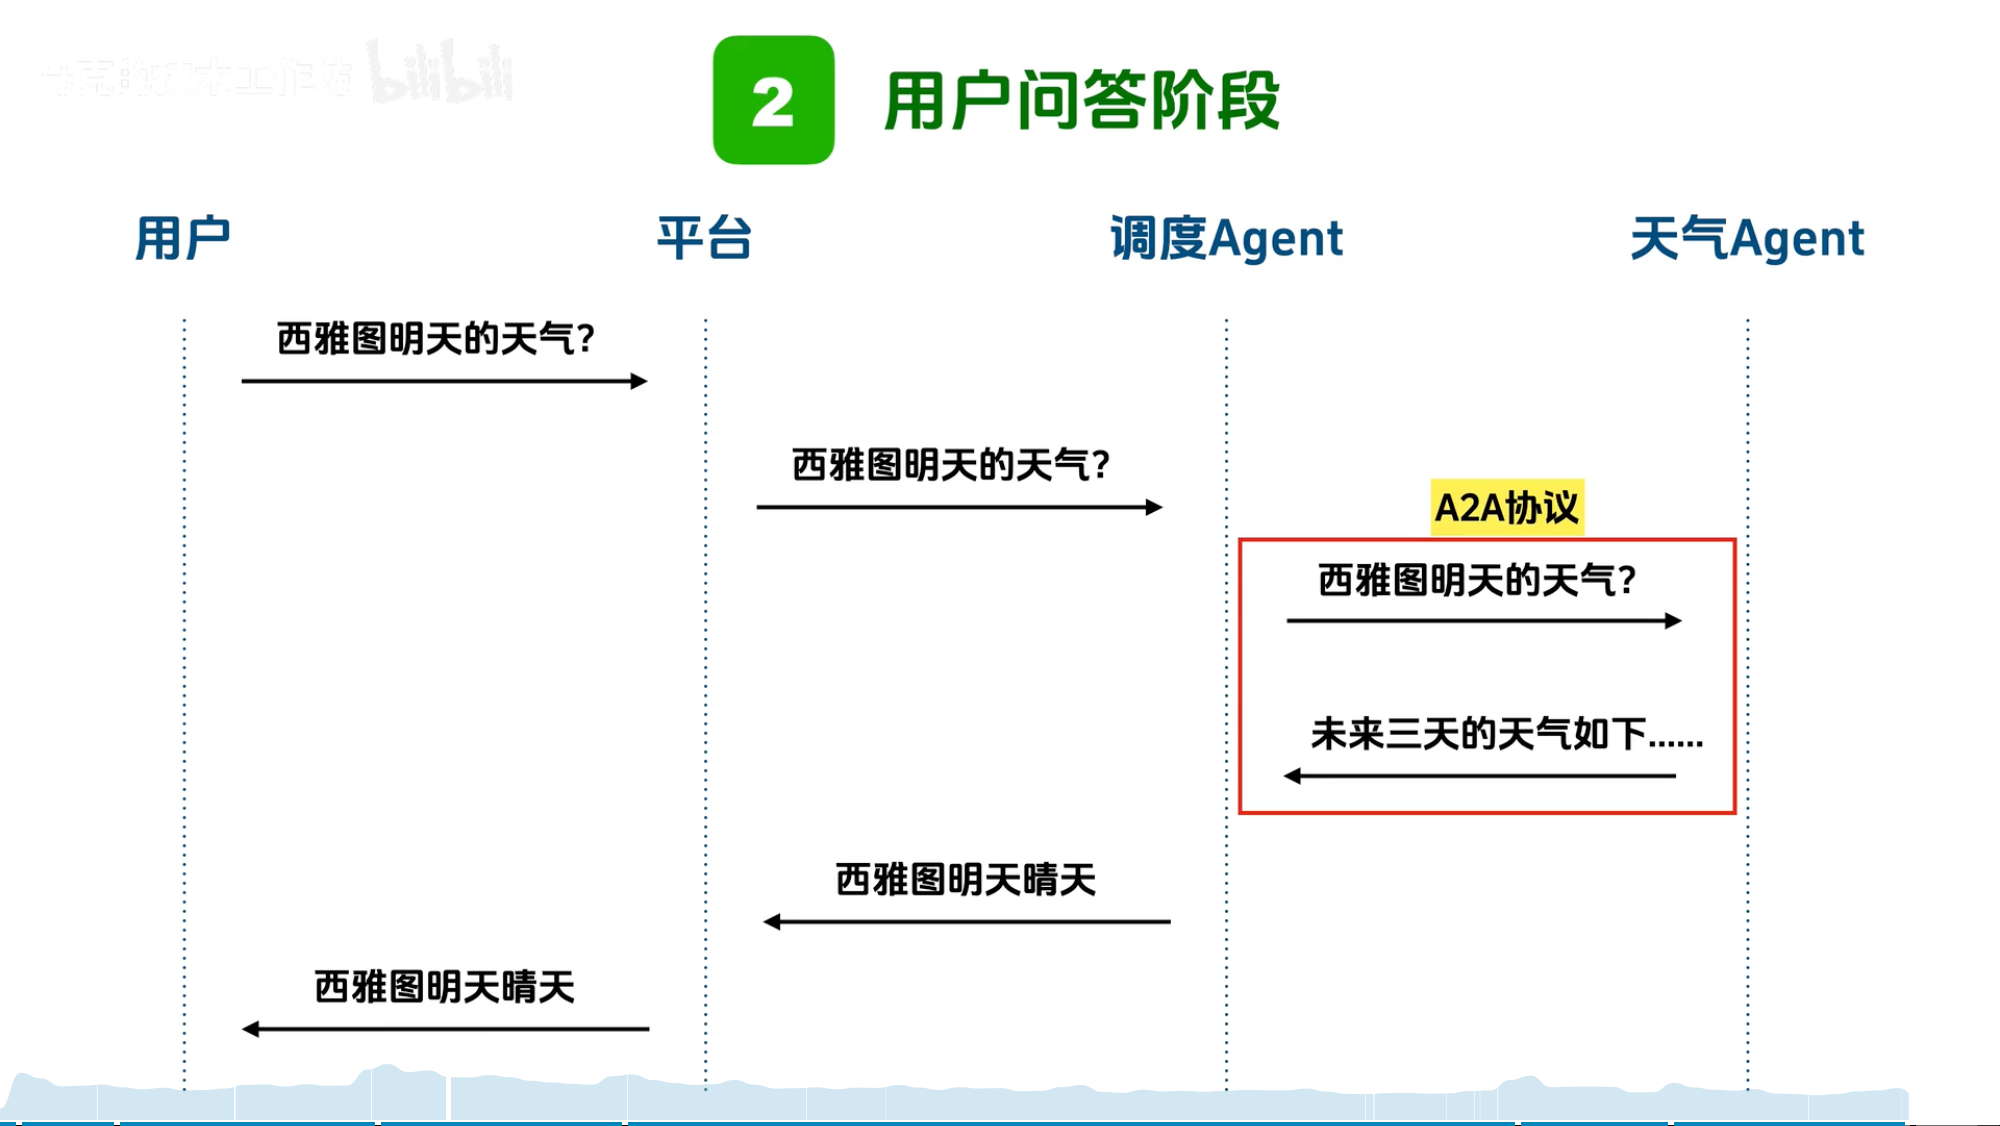
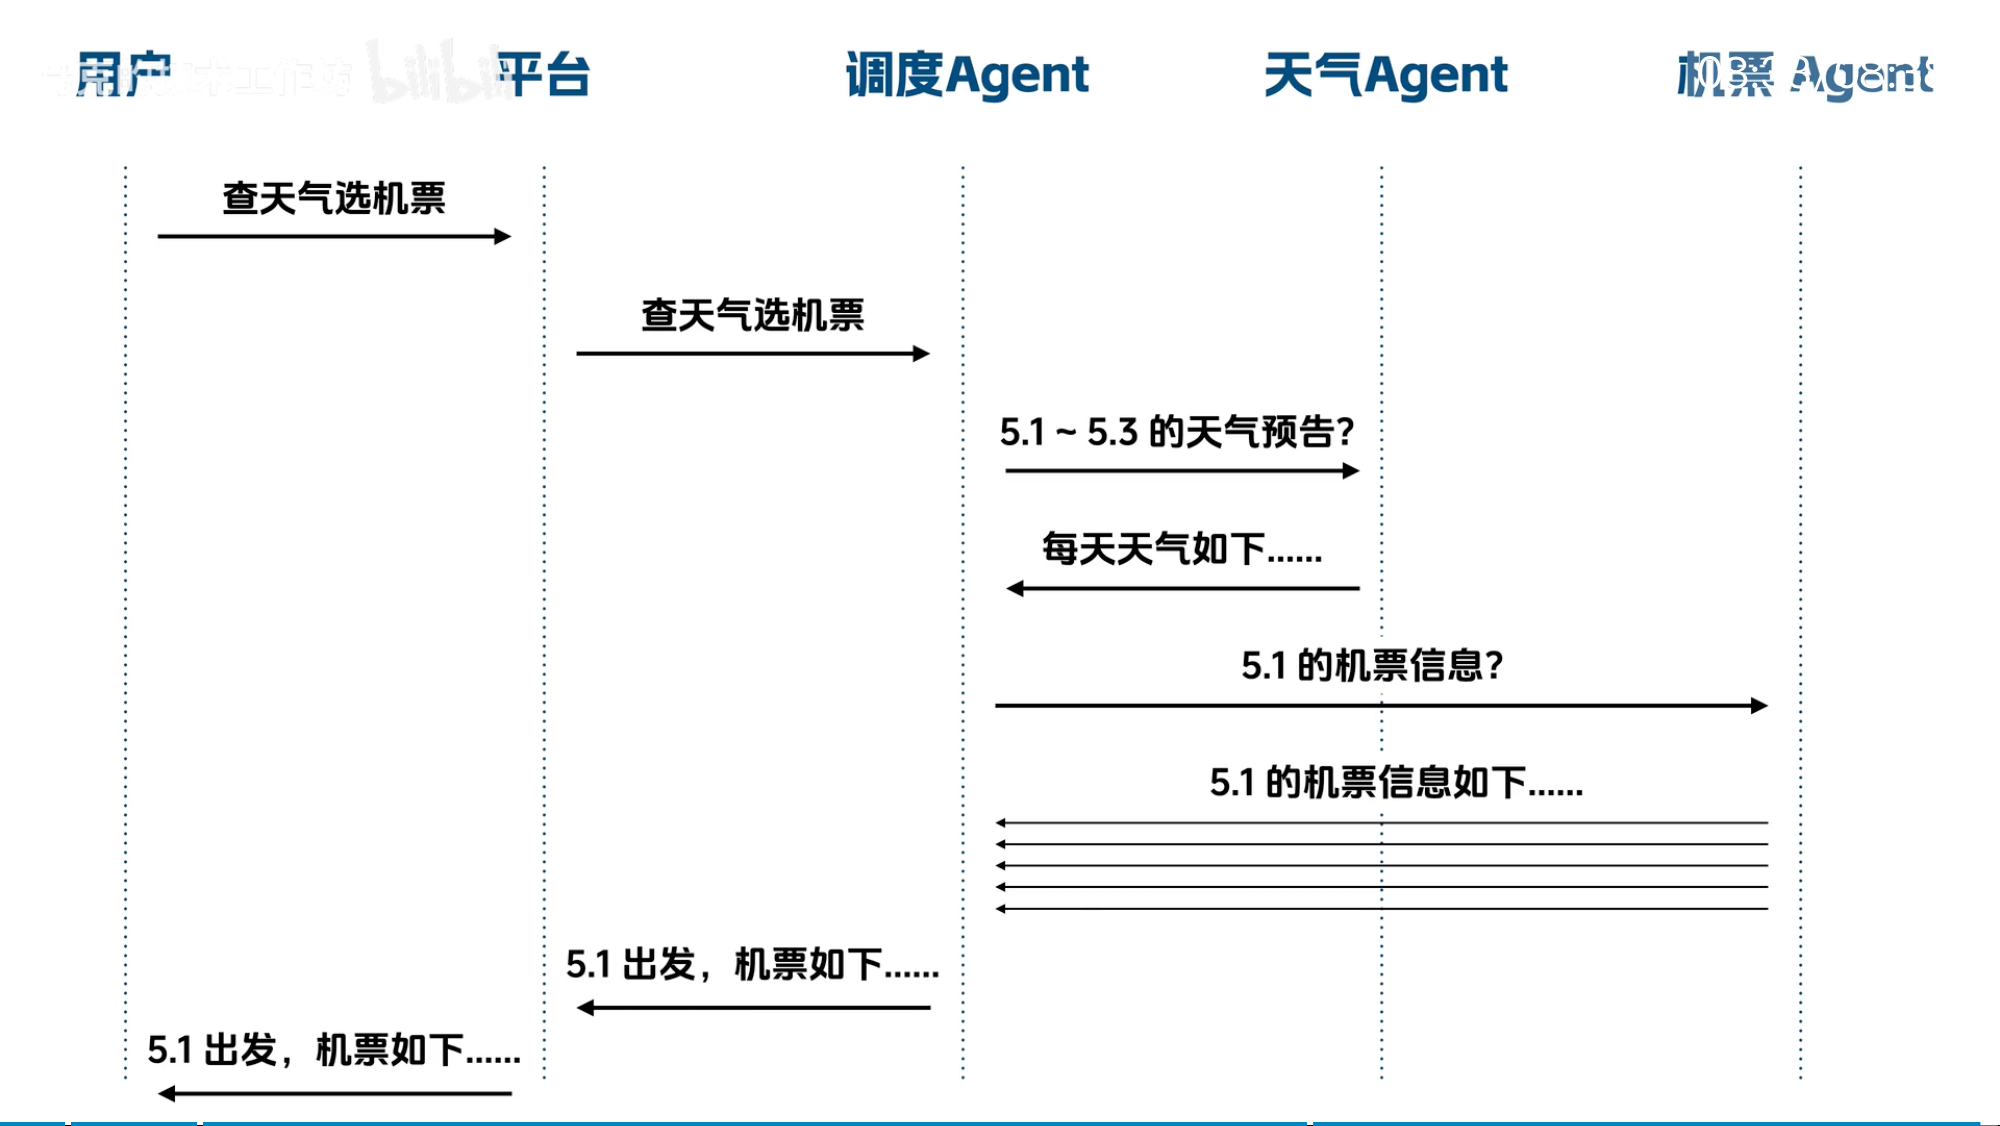
Agent 的概念、原理与构建模式
Agent 的概念、原理与构建模式 —— 从零打造一个简化版的 Claude Code_哔哩哔哩...
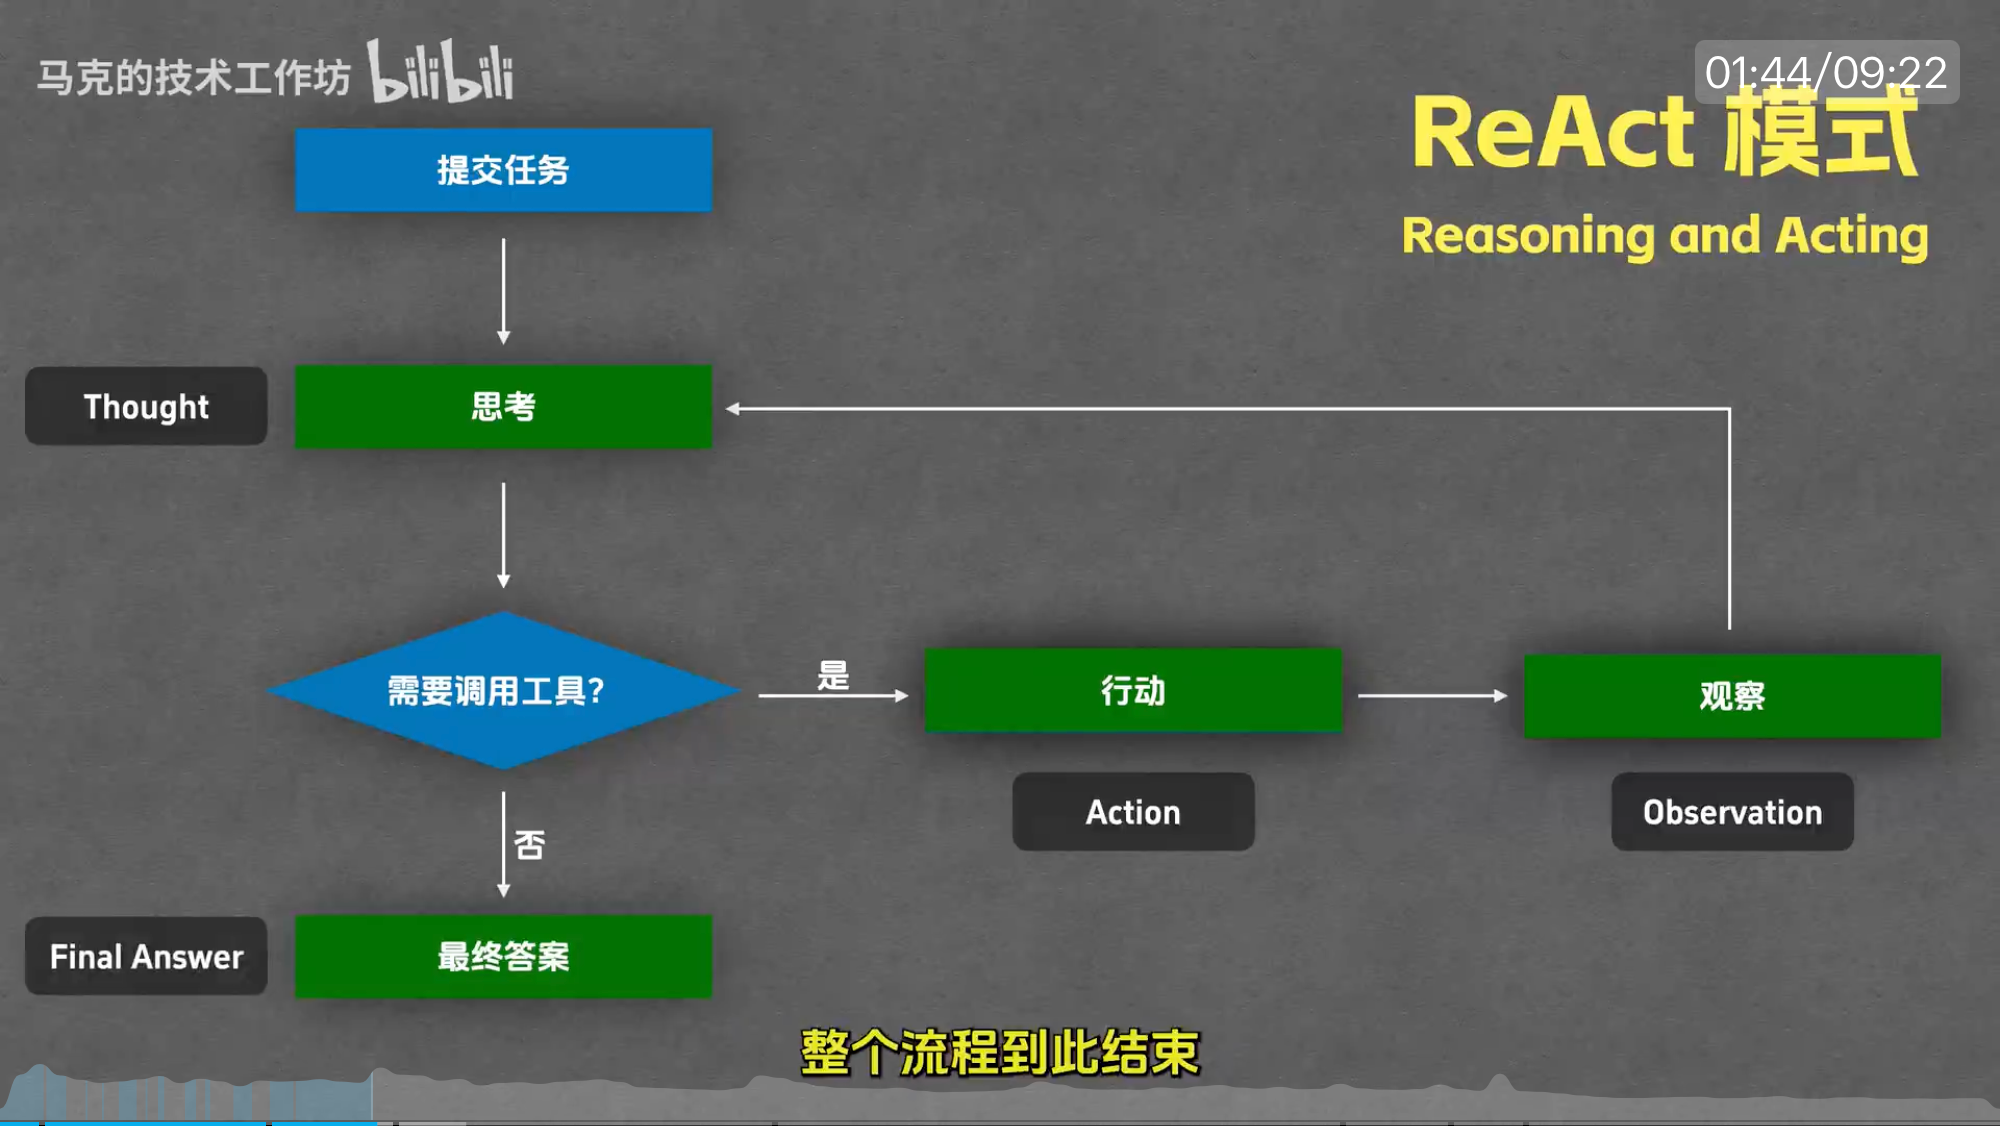
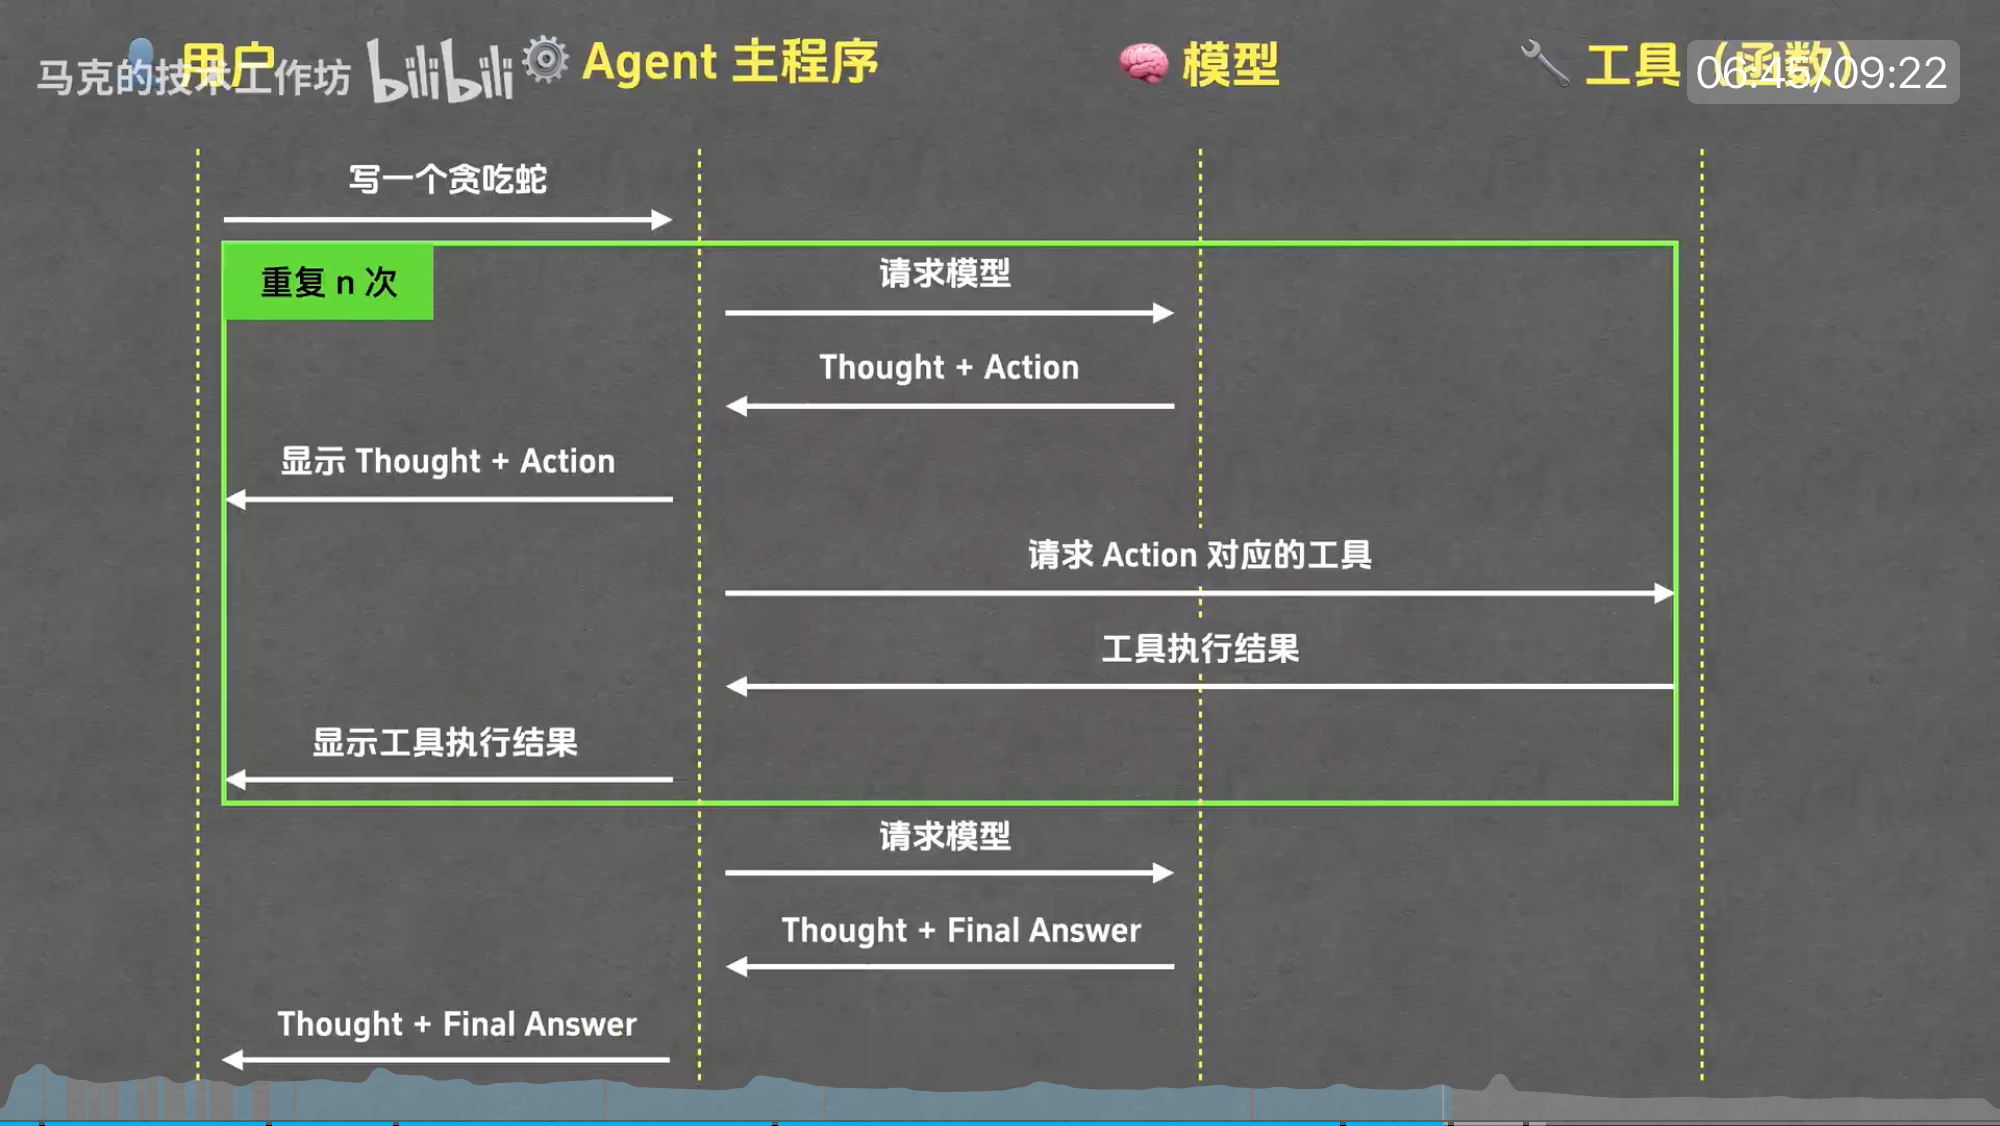
ReAct 模式:
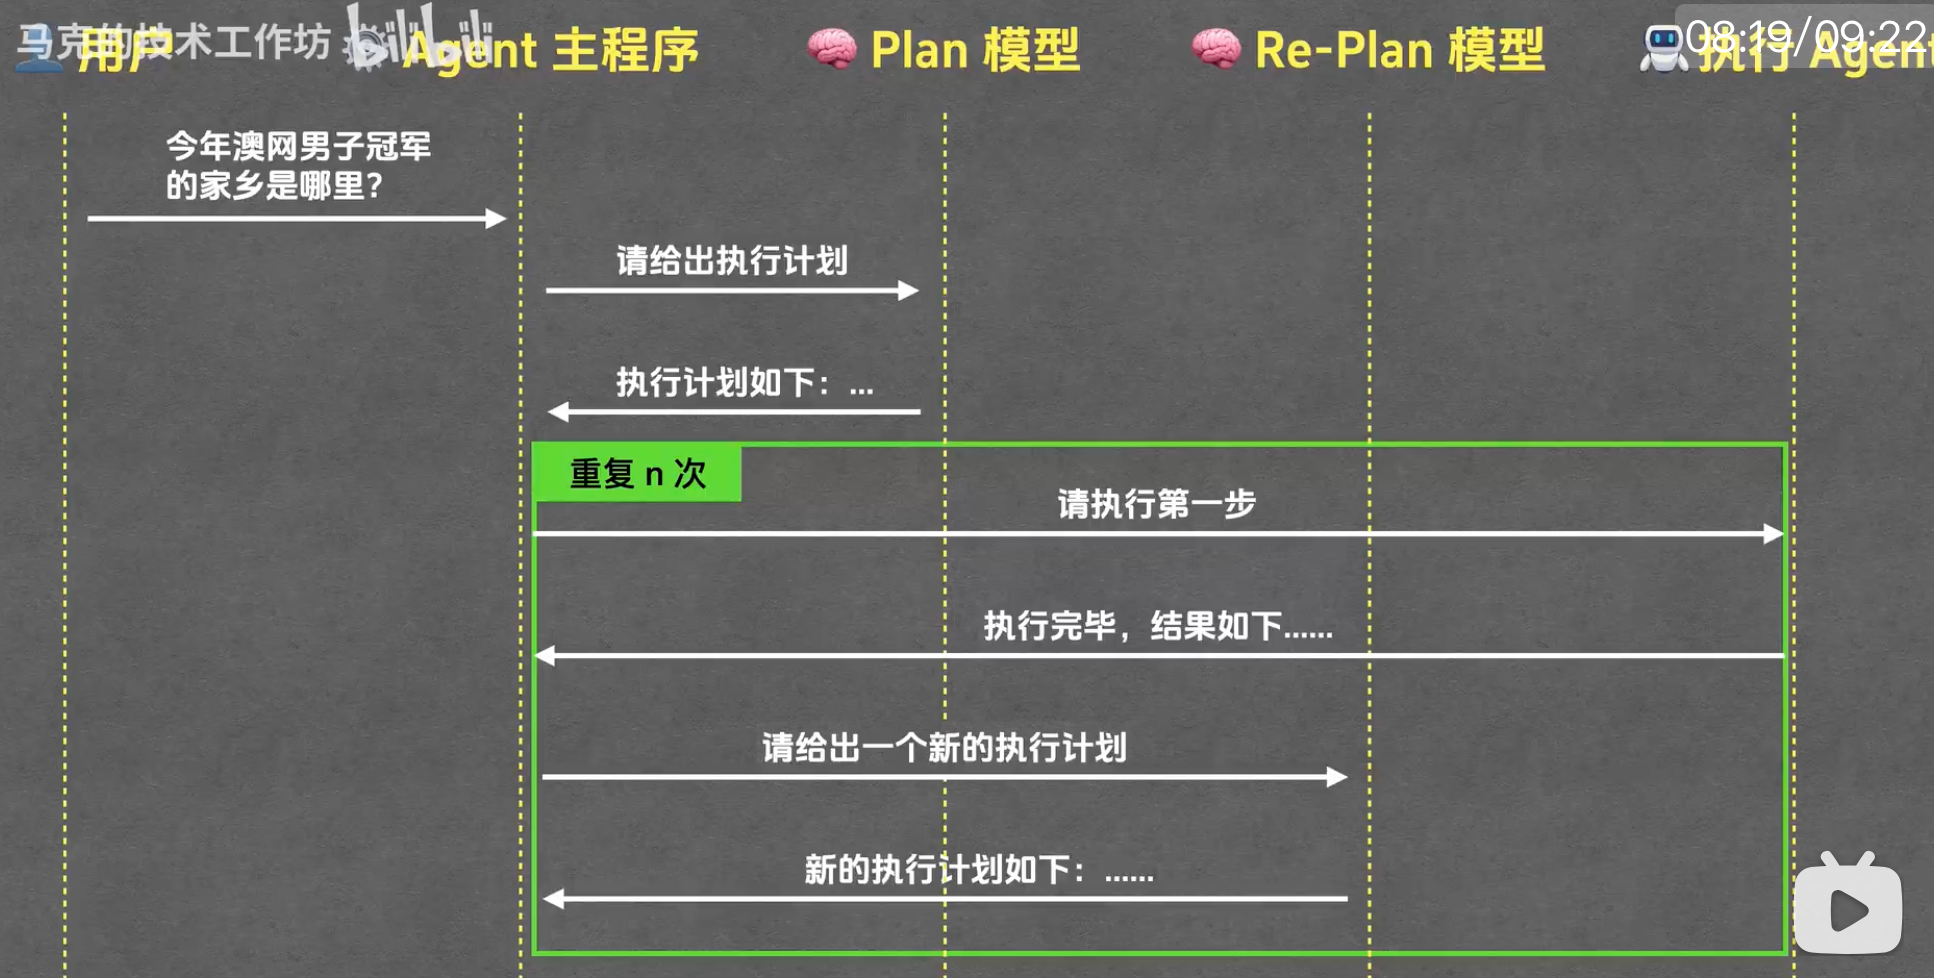
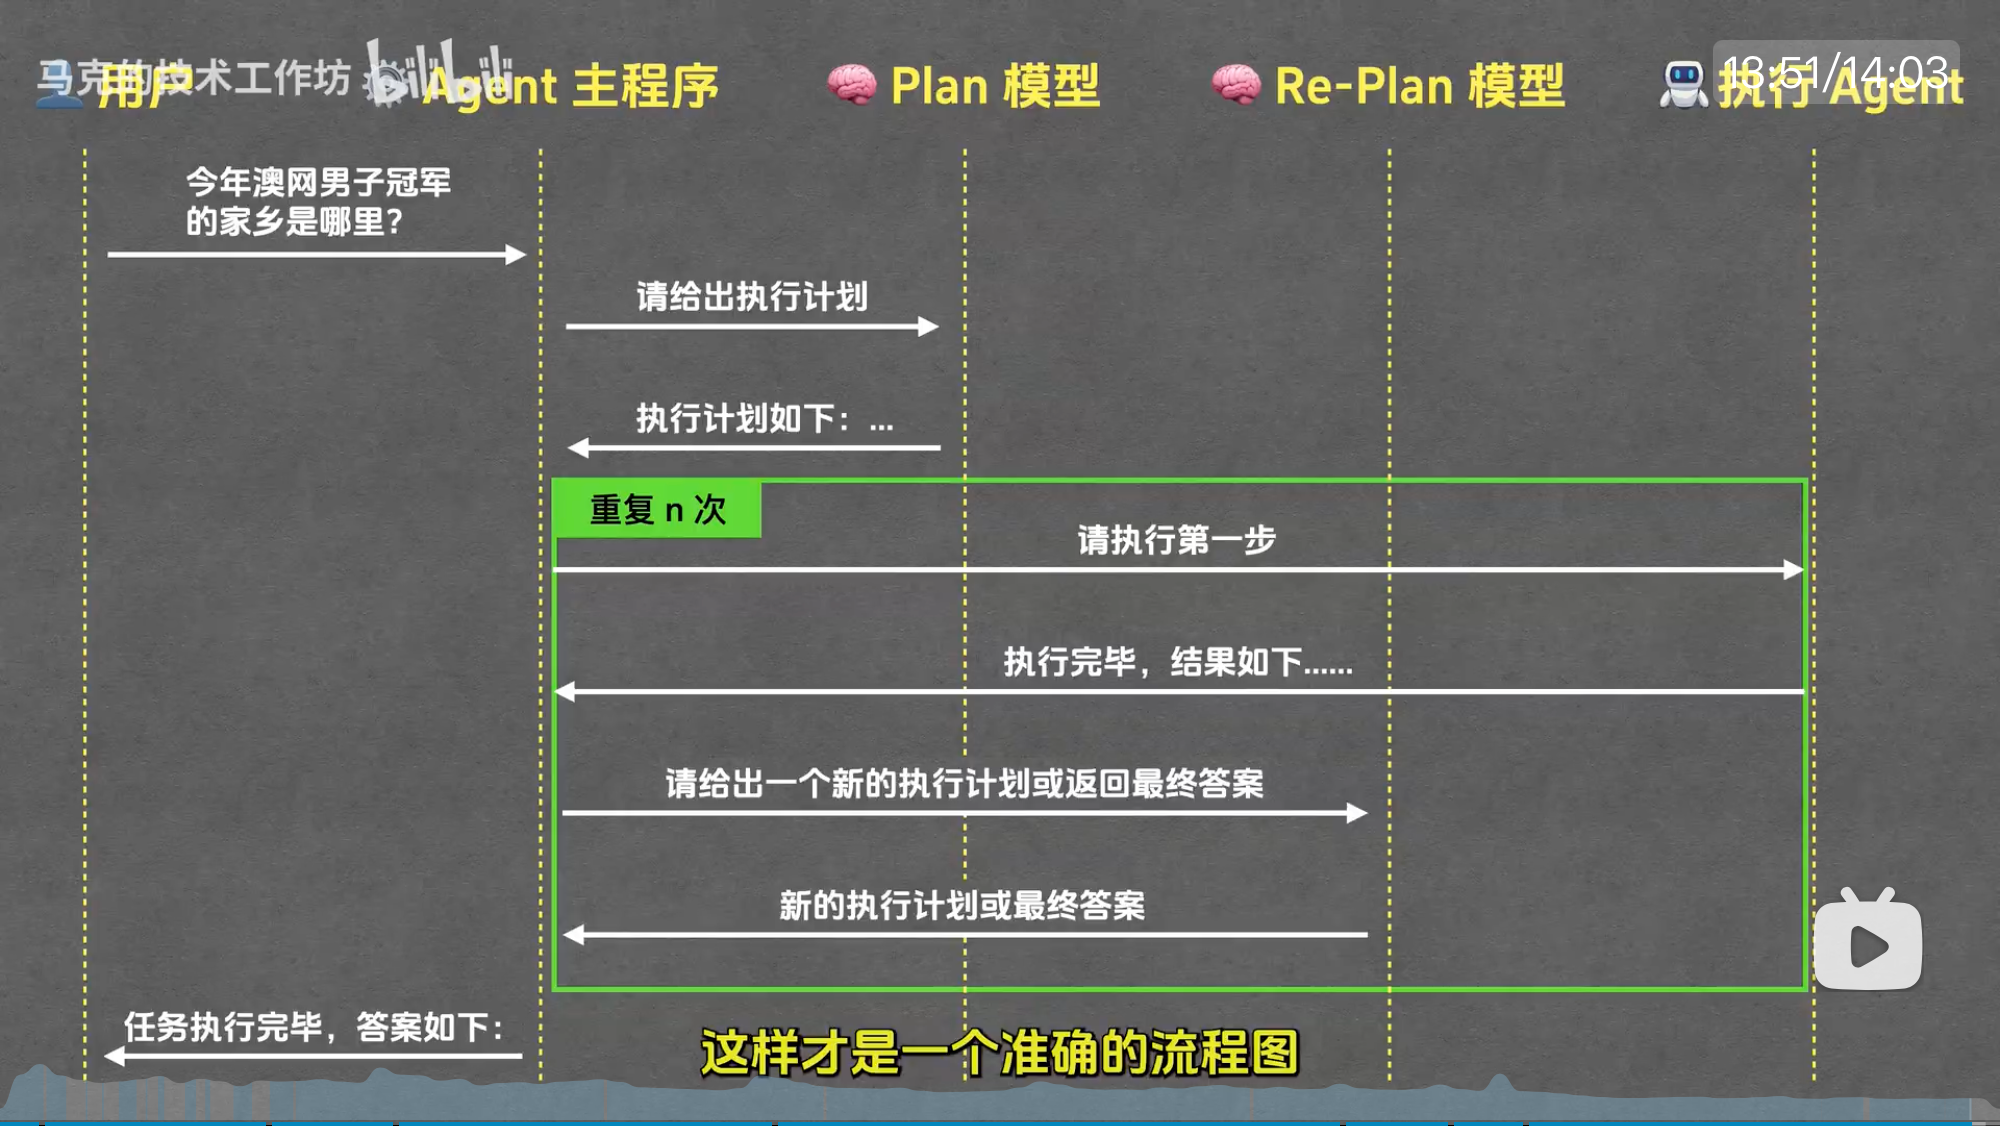
Plan-and-excute 模式:
对于这里做 执行的部分也可能采用 ReAct 模式
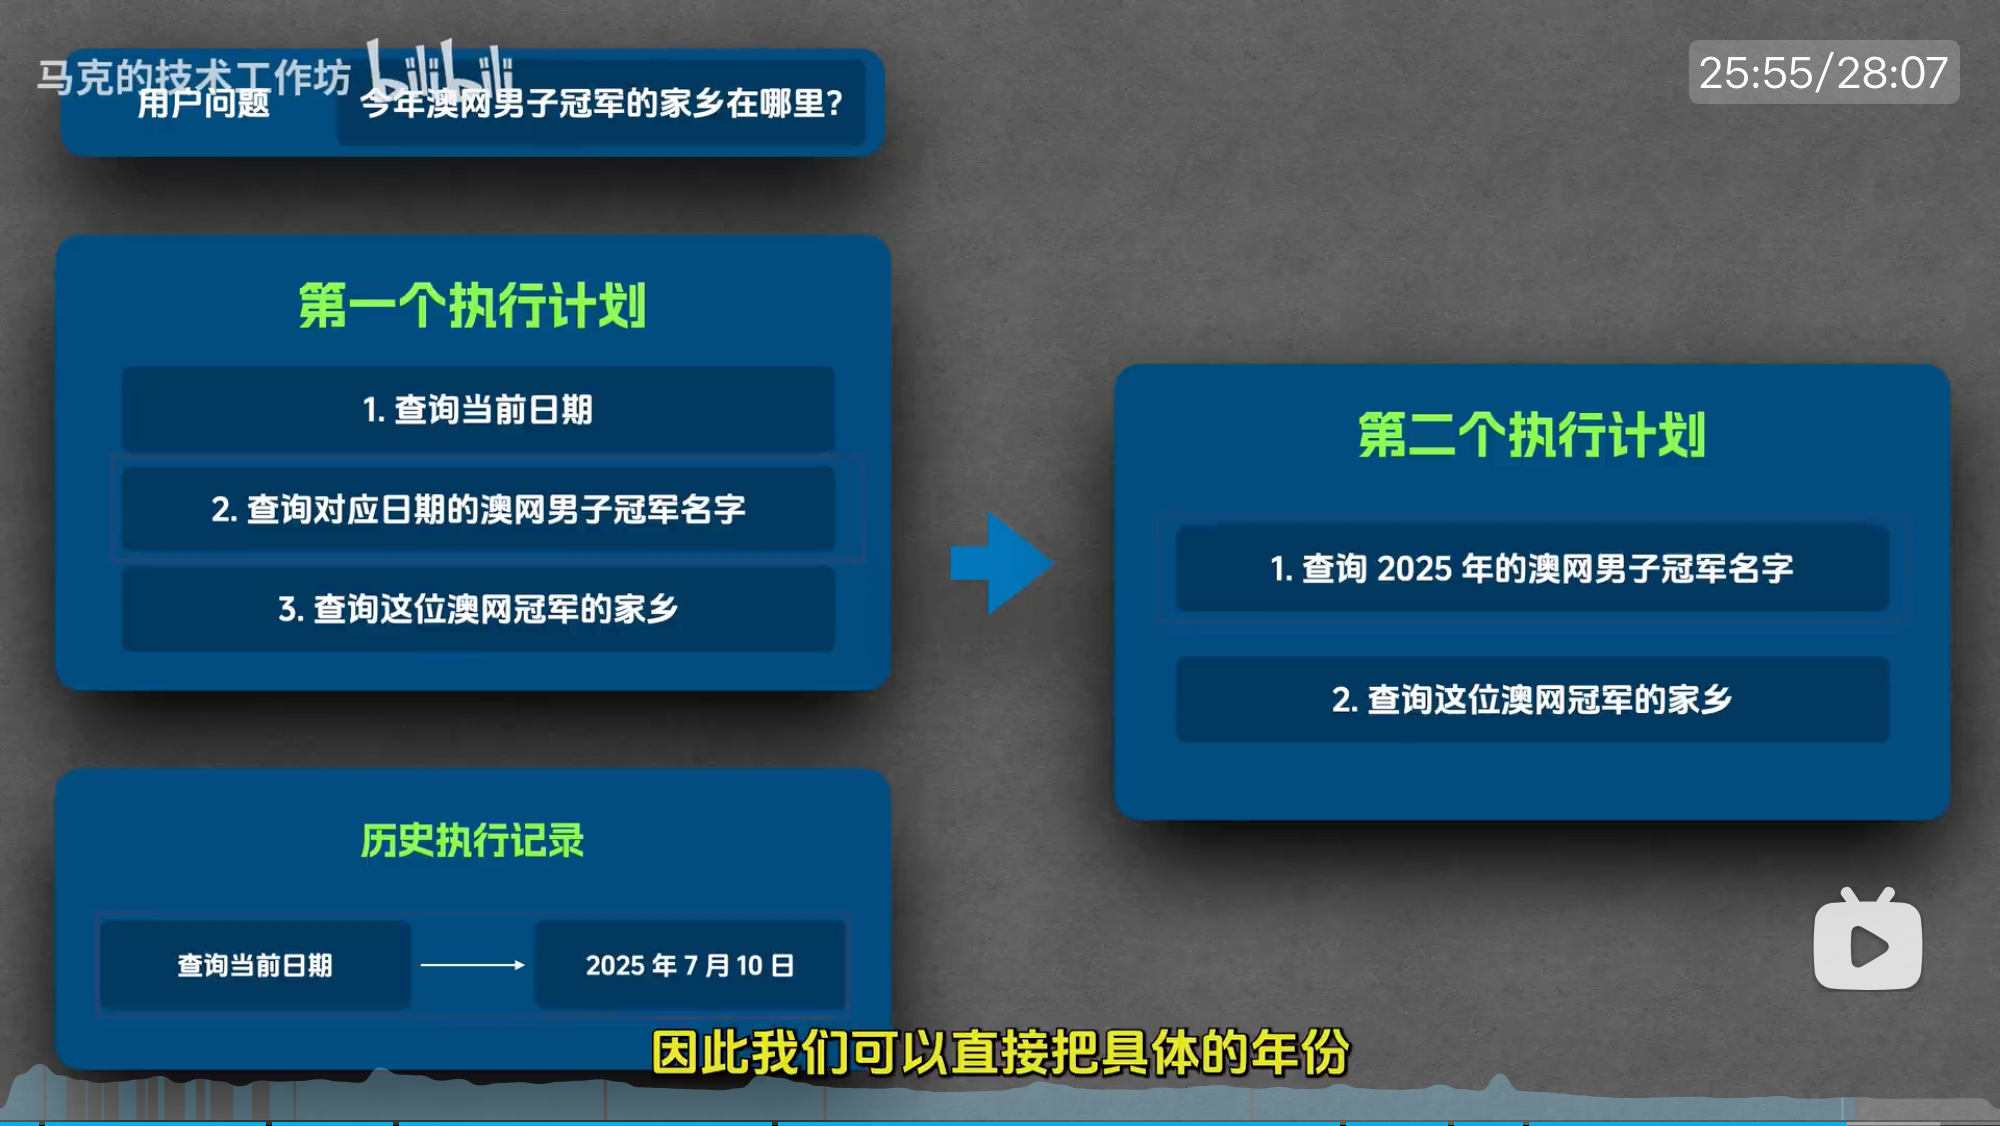
示例:
第一步:
第二轮:
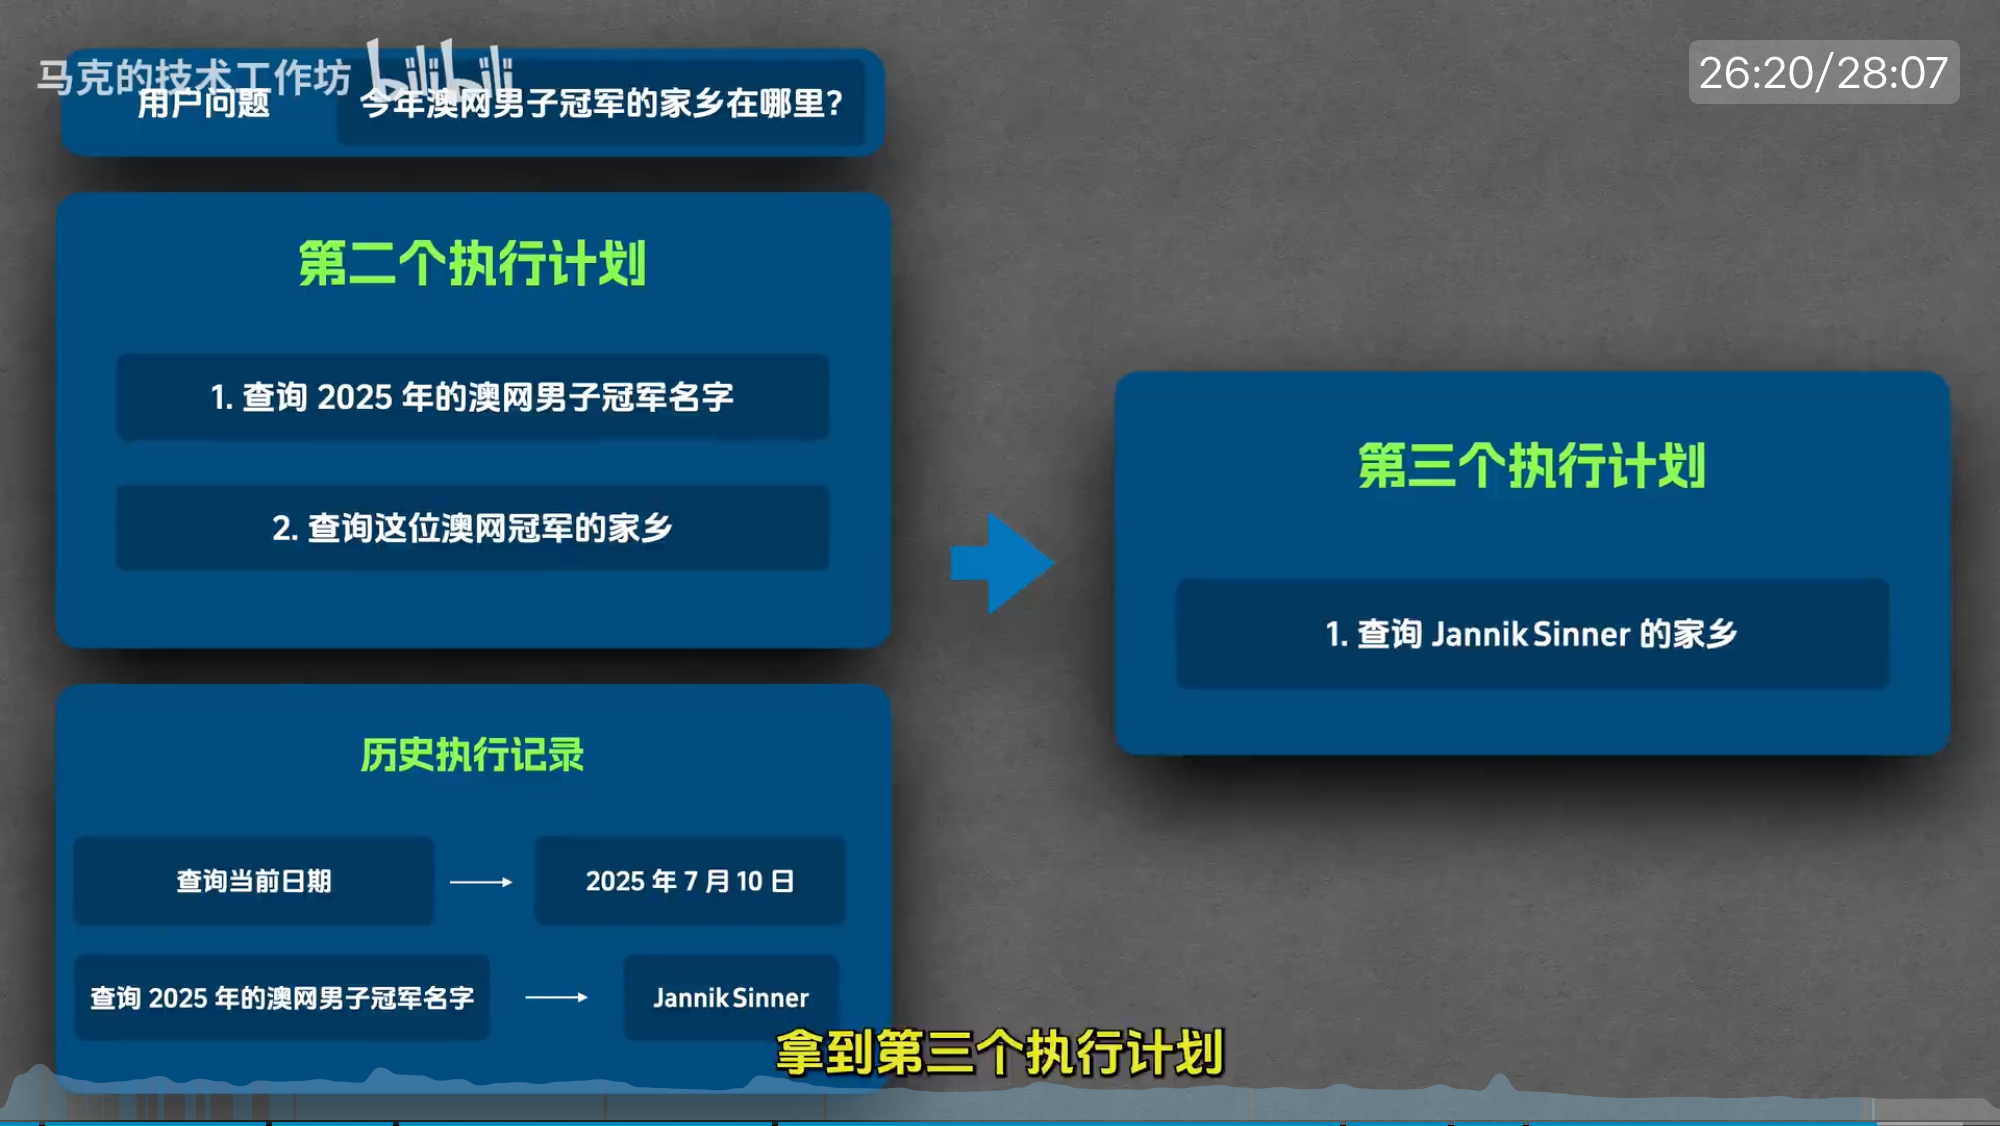
第三轮:
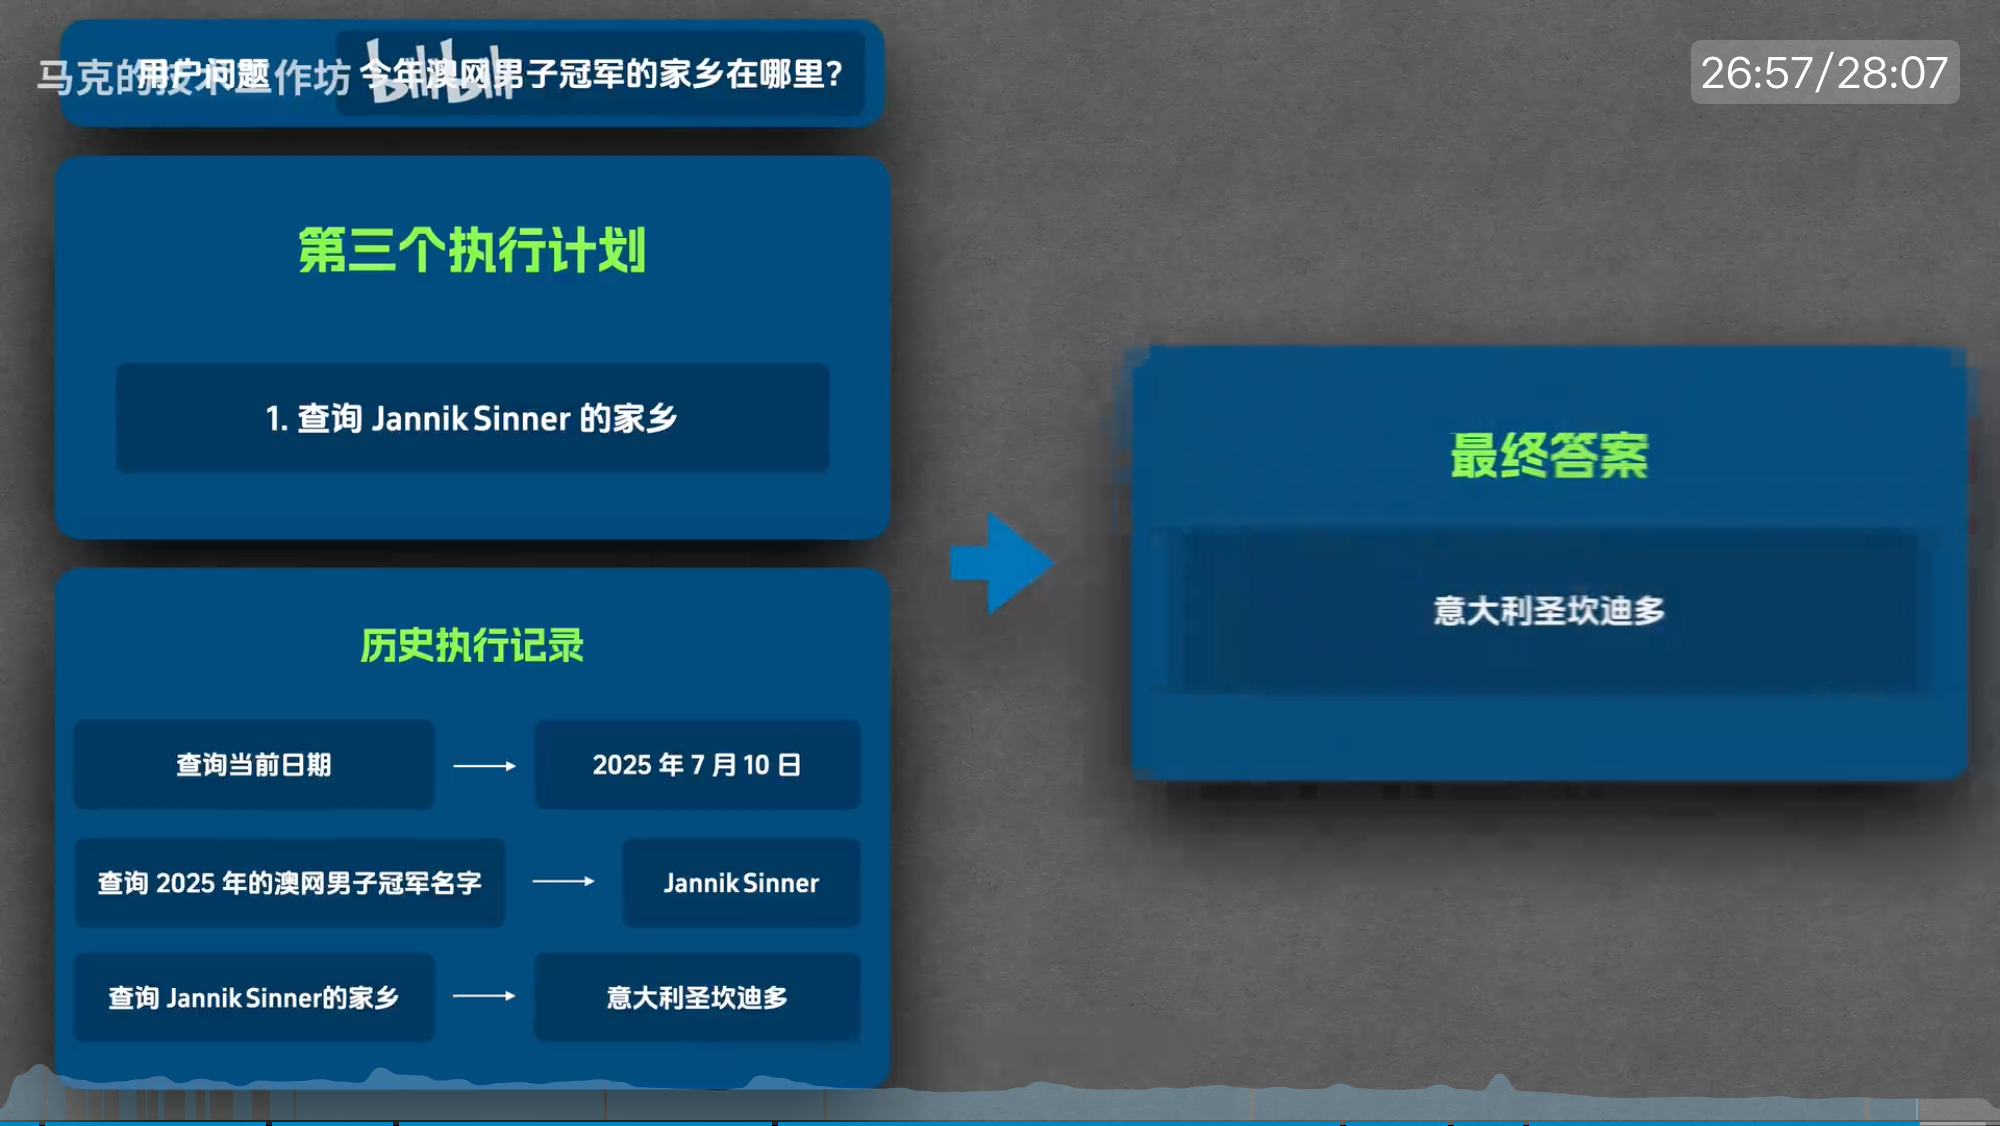
在最后一个位置的时候:流程图则是「最终的答案如下」了
ReAct 和 CodeAct-Agent
视频链接:ReAct和CodeAct-Agent调用外部工具的两种方法,从原理到实战-工具调用/MCP/Fun...
1. ReAct(Reasoning + Acting)
- 来源:2022 年发表的论文(10 月 6 日),早于 OpenAI 的 Function Calling(2023 年 6 月)
- 本质:一种提示词工程技巧,不需要微调模型,通过 prompt 让模型交替输出
Thought → Action → Observation循环 - 工作流程:
- Thought(模型思考需要什么工具)
- Action(调用外部工具,如搜索、计算器)
- Observation(工具返回结果,加入上下文)
- 重复直到得出最终 Answer
- 缺点:
- 工具必须提前全部定义好,扩展性受限
- 无法灵活组合工具,复杂公式需要多次串行调用
- 早期(无 Function Calling)靠字符串解析,成功率不稳定
2. CodeAct(Coding + Acting)
- 来源:苹果机器学习研究组提出的论文
- 核心思想:既然大模型会写代码,为什么不直接让它写代码?
- 工作流程:
- 模型直接输出代码片段(JavaScript/Python)
- 在沙箱环境中执行代码
- 代码的
console.log/print输出作为结果 - 如果有报错,把错误信息喂回模型让它自己修
- 优点:
- 可调用语言内置的全部标准库(如
math、matplotlib) - 可以嵌套组合工具,一次代码输出完成多次运算
- 表达能力几乎没有限制(for 循环、条件判断等)
- 调用次数大幅减少,成功率更高
- 可调用语言内置的全部标准库(如
- 原型:MANUS 用的就是 CodeAct 架构
RAG*
即检索增强生成
一个基本的运行流程:
-
先将文档分成多段,挑选出相关的几个片段
-
发送的时候就将相关的片段和问题一起发送给 LLM,,这样 LLM 就只会感知到相关的片段而非完整的文档(这样省 token 且可以提升准确率)
-
如何选择的?
-
如何分片的?
基本流程:
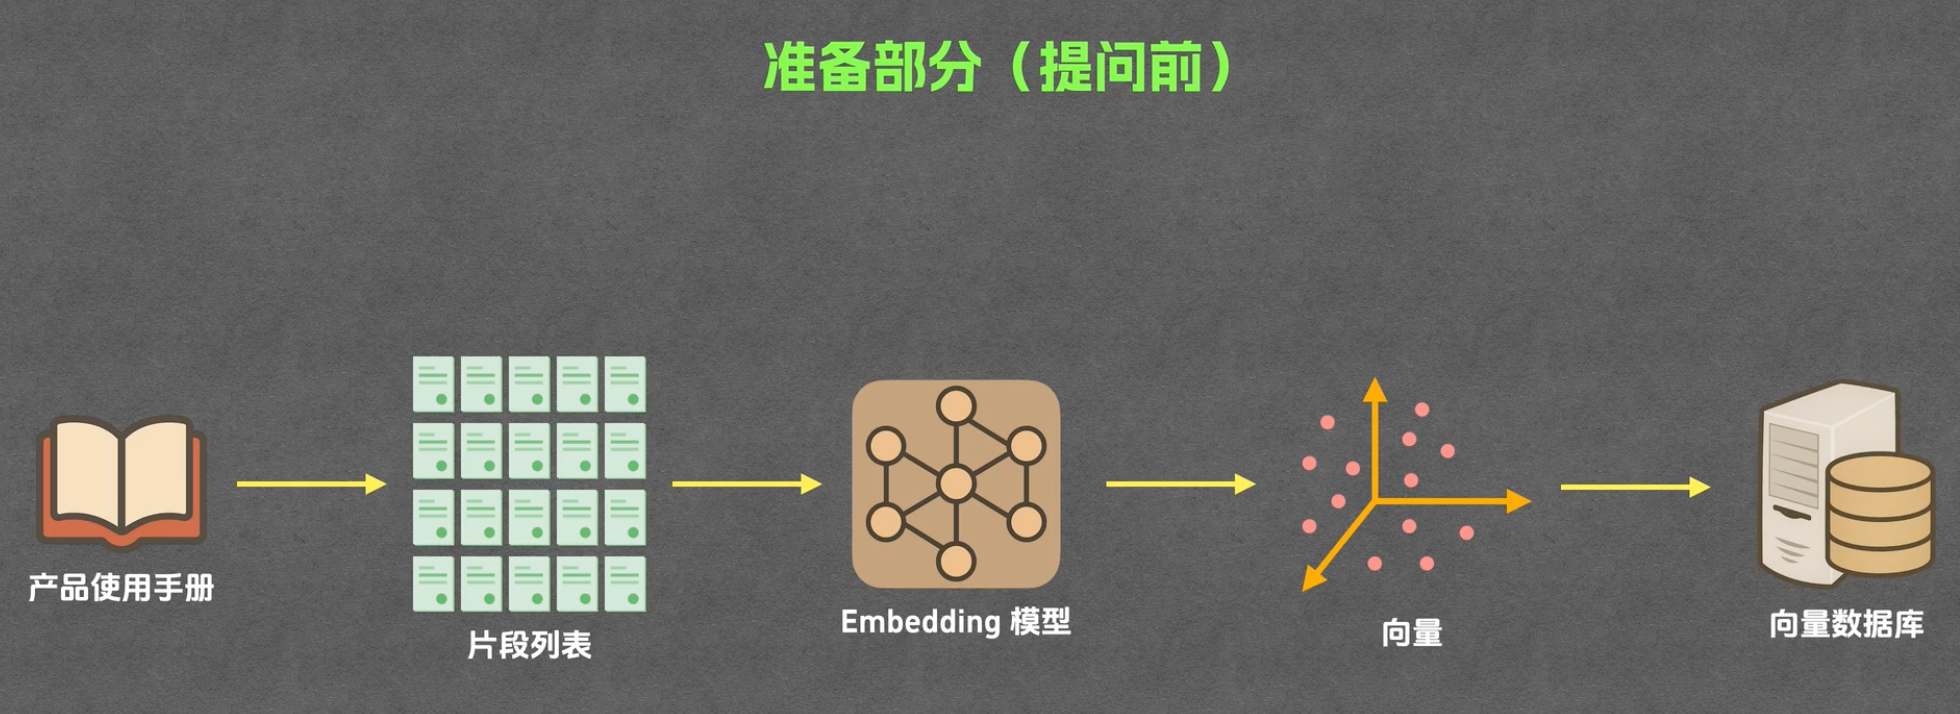
准备(提问前):分片,索引
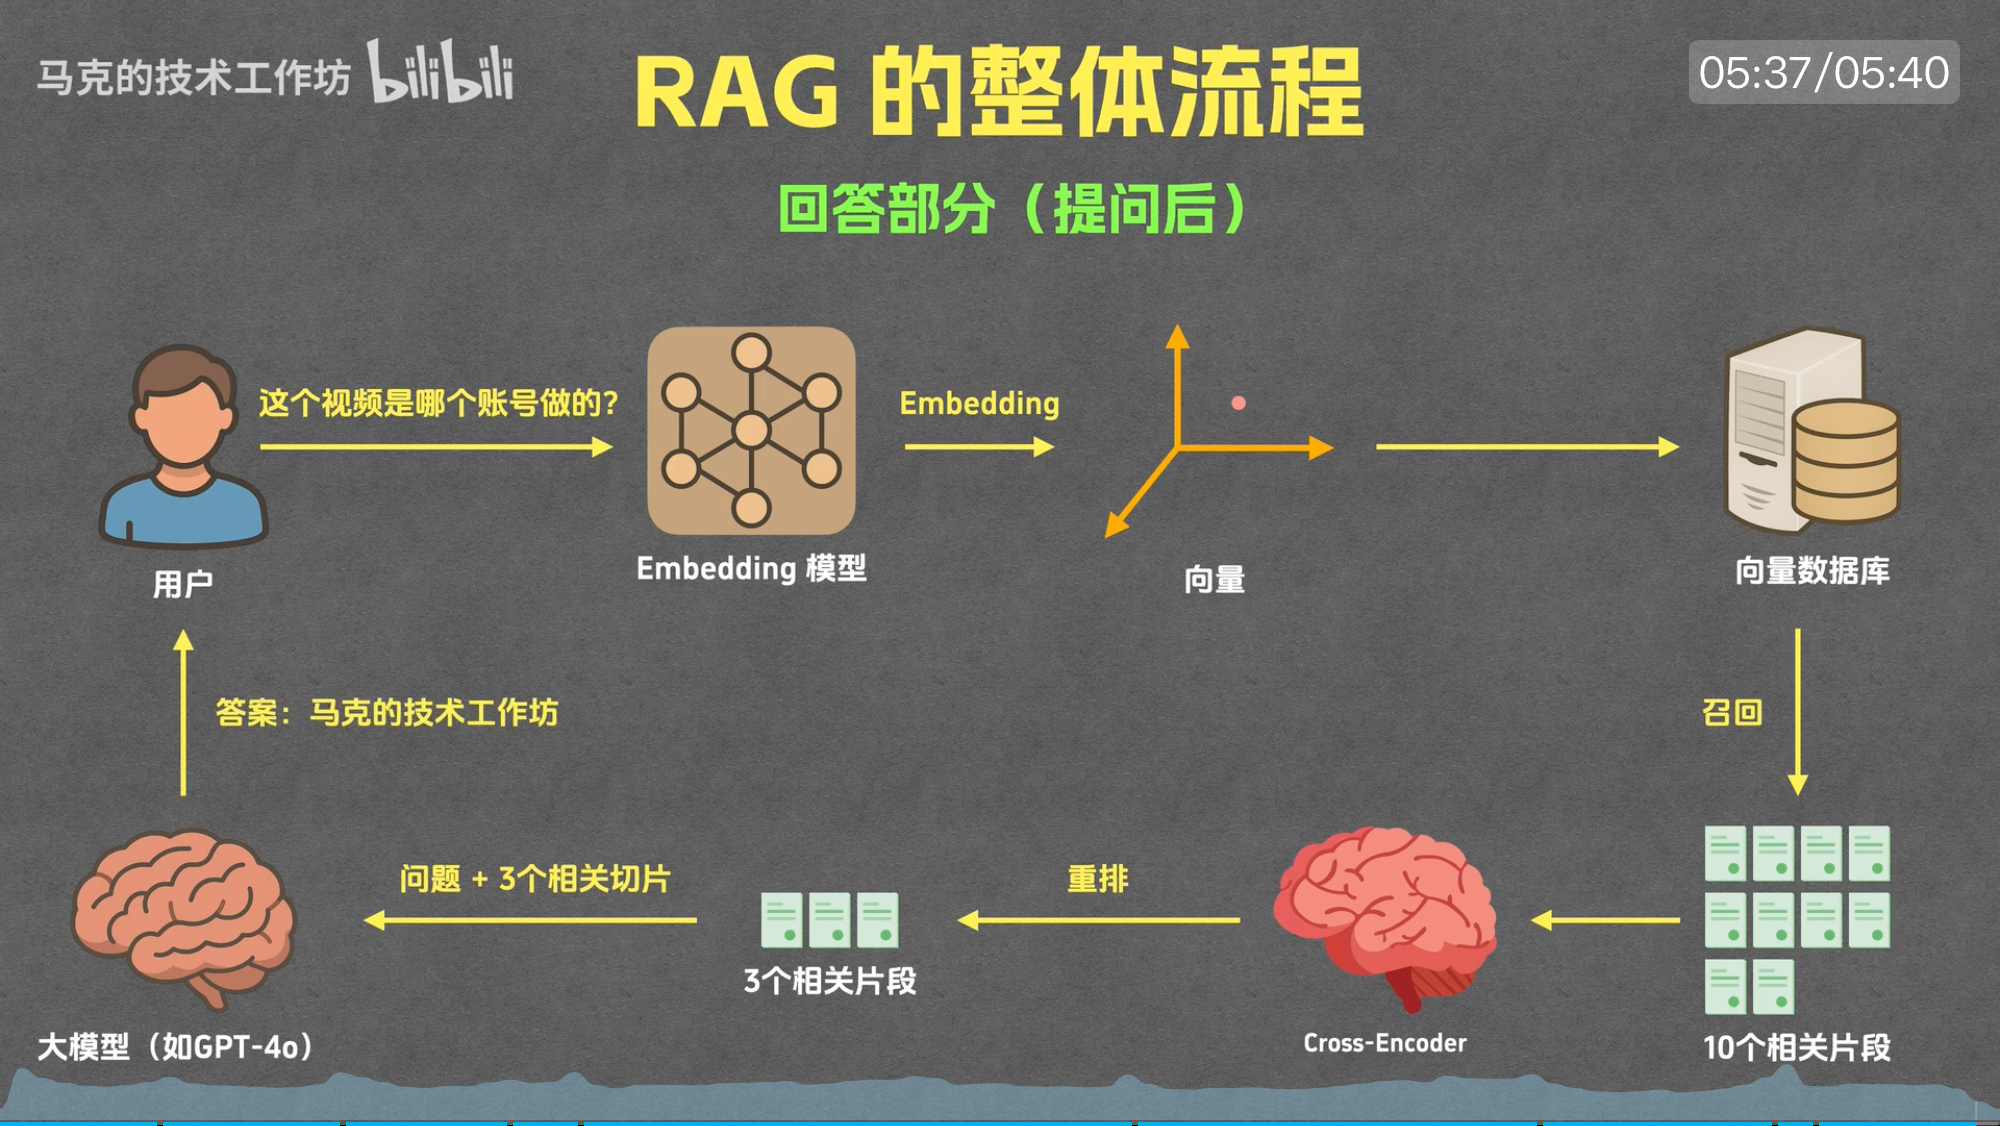
回答(提问后):召回,重排,生成
分片:有很多种的分片方式,总之要做到的都是将文档分为若干份
索引:通过 embedding 将片段文本转化为向量,然后将片段文本和片段向量存入向量数据库中
embedding:将文本转为向量的一个过程
向量数据库:存储和查询向量的数据库,其中提供了计算向量相似度相关的函数
召回:搜索与用户问题相关片段的过程
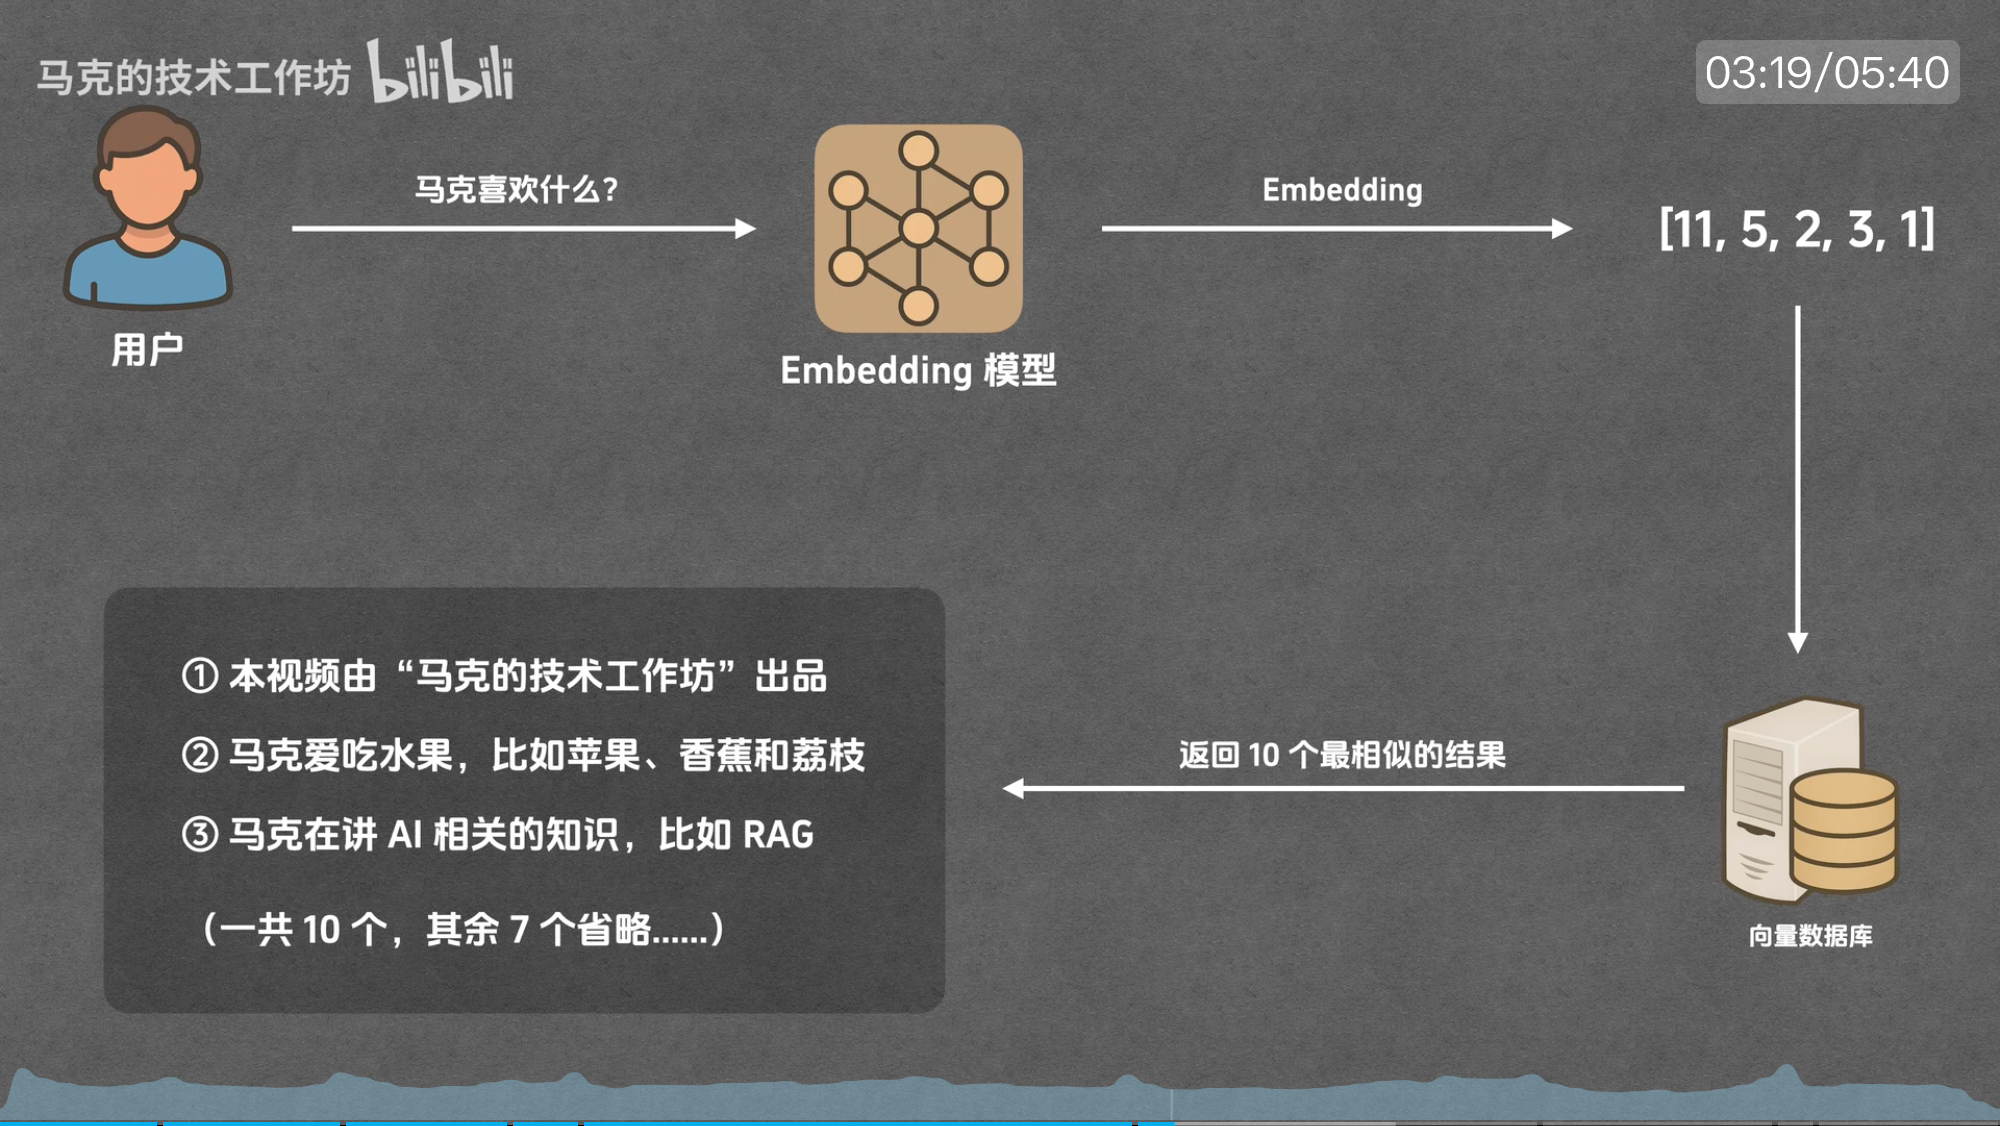
显然,这里要返回最相似的结果,就需要「计算向量相似度」
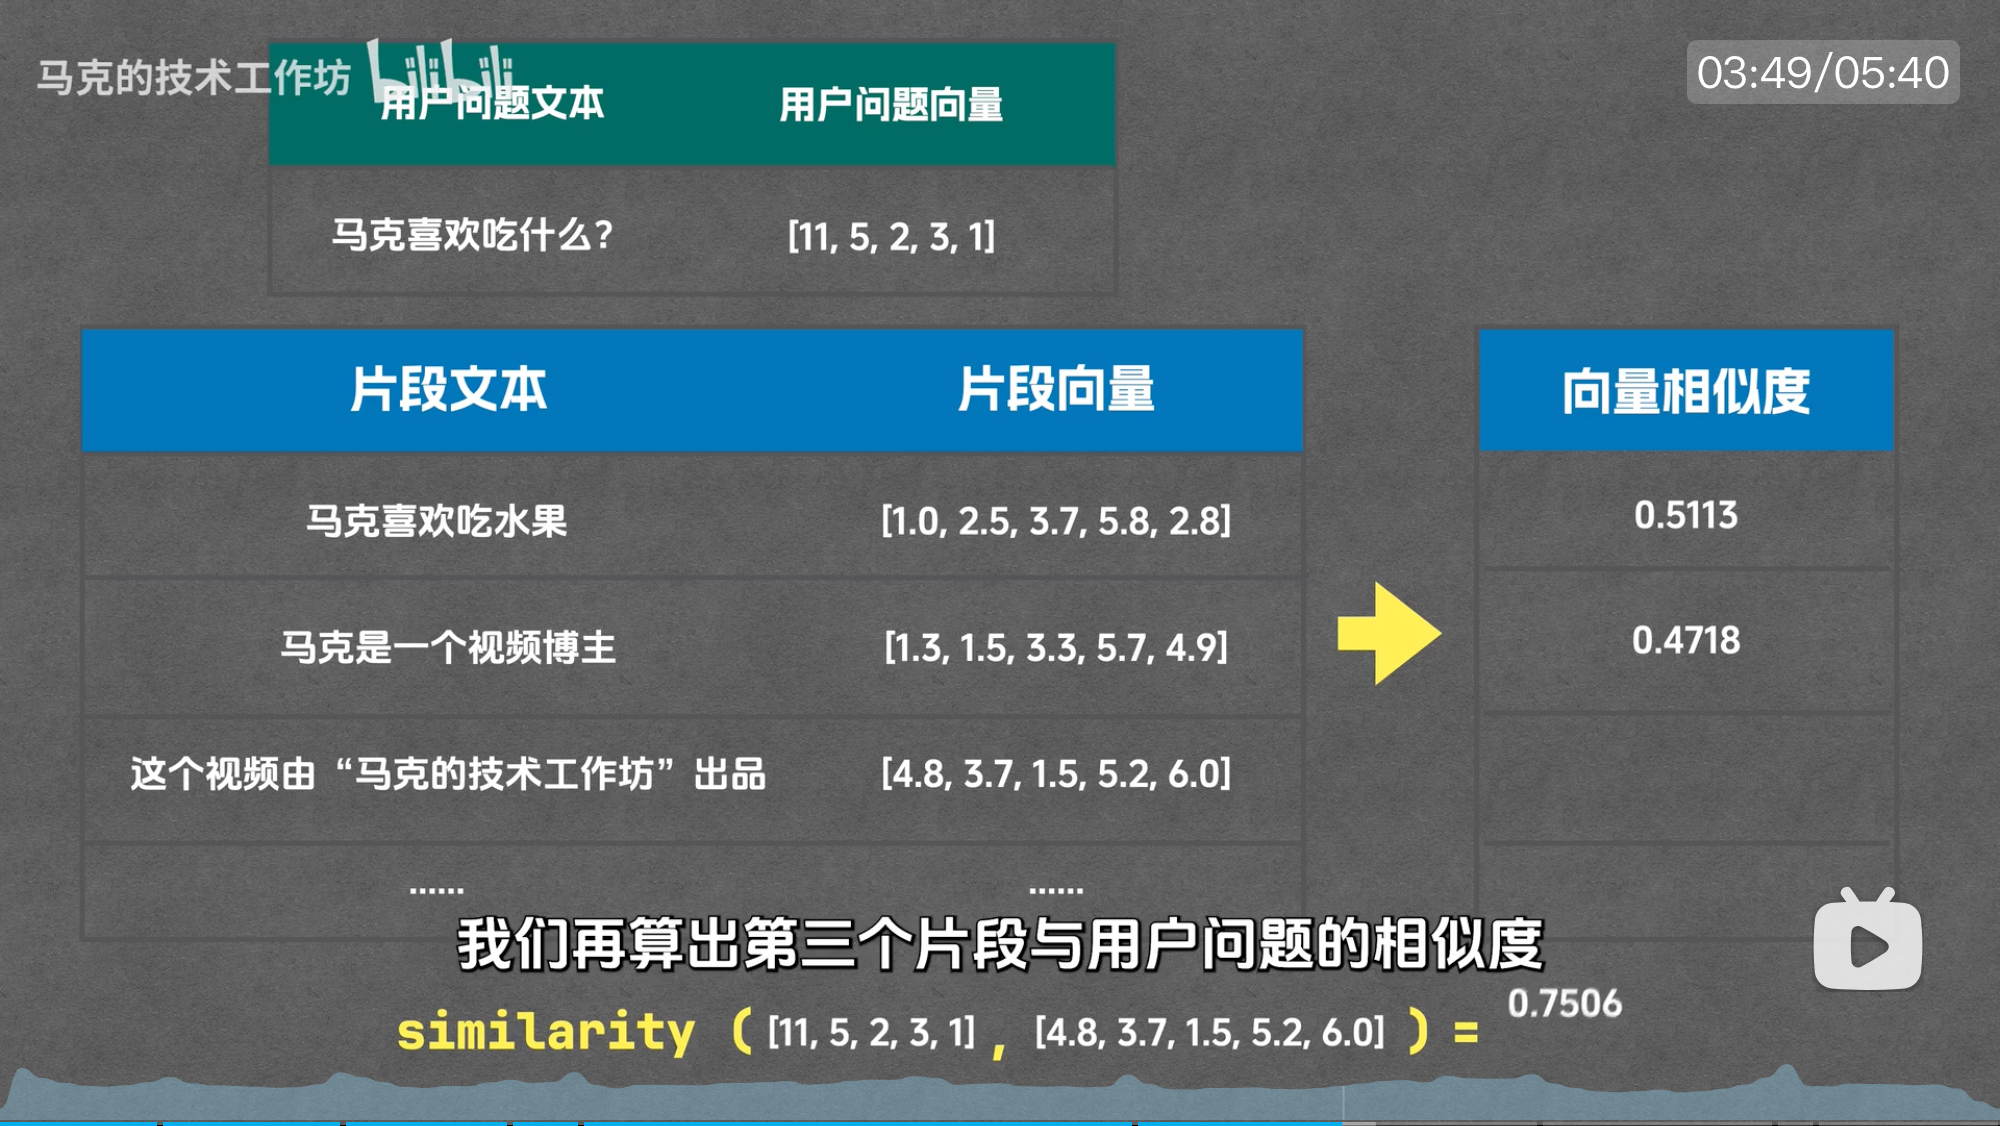
这里将问题向量和片段向量做某个「相似度的运算」(当然方式不唯一),算出相似度,然后将相似度进行排序即可
计算方式:
- 余弦相似度:根据向量夹角的余弦值来判定相似度
- 欧氏距离:距离越小,相似度越高
- 点积:乘积越大,相似度越高
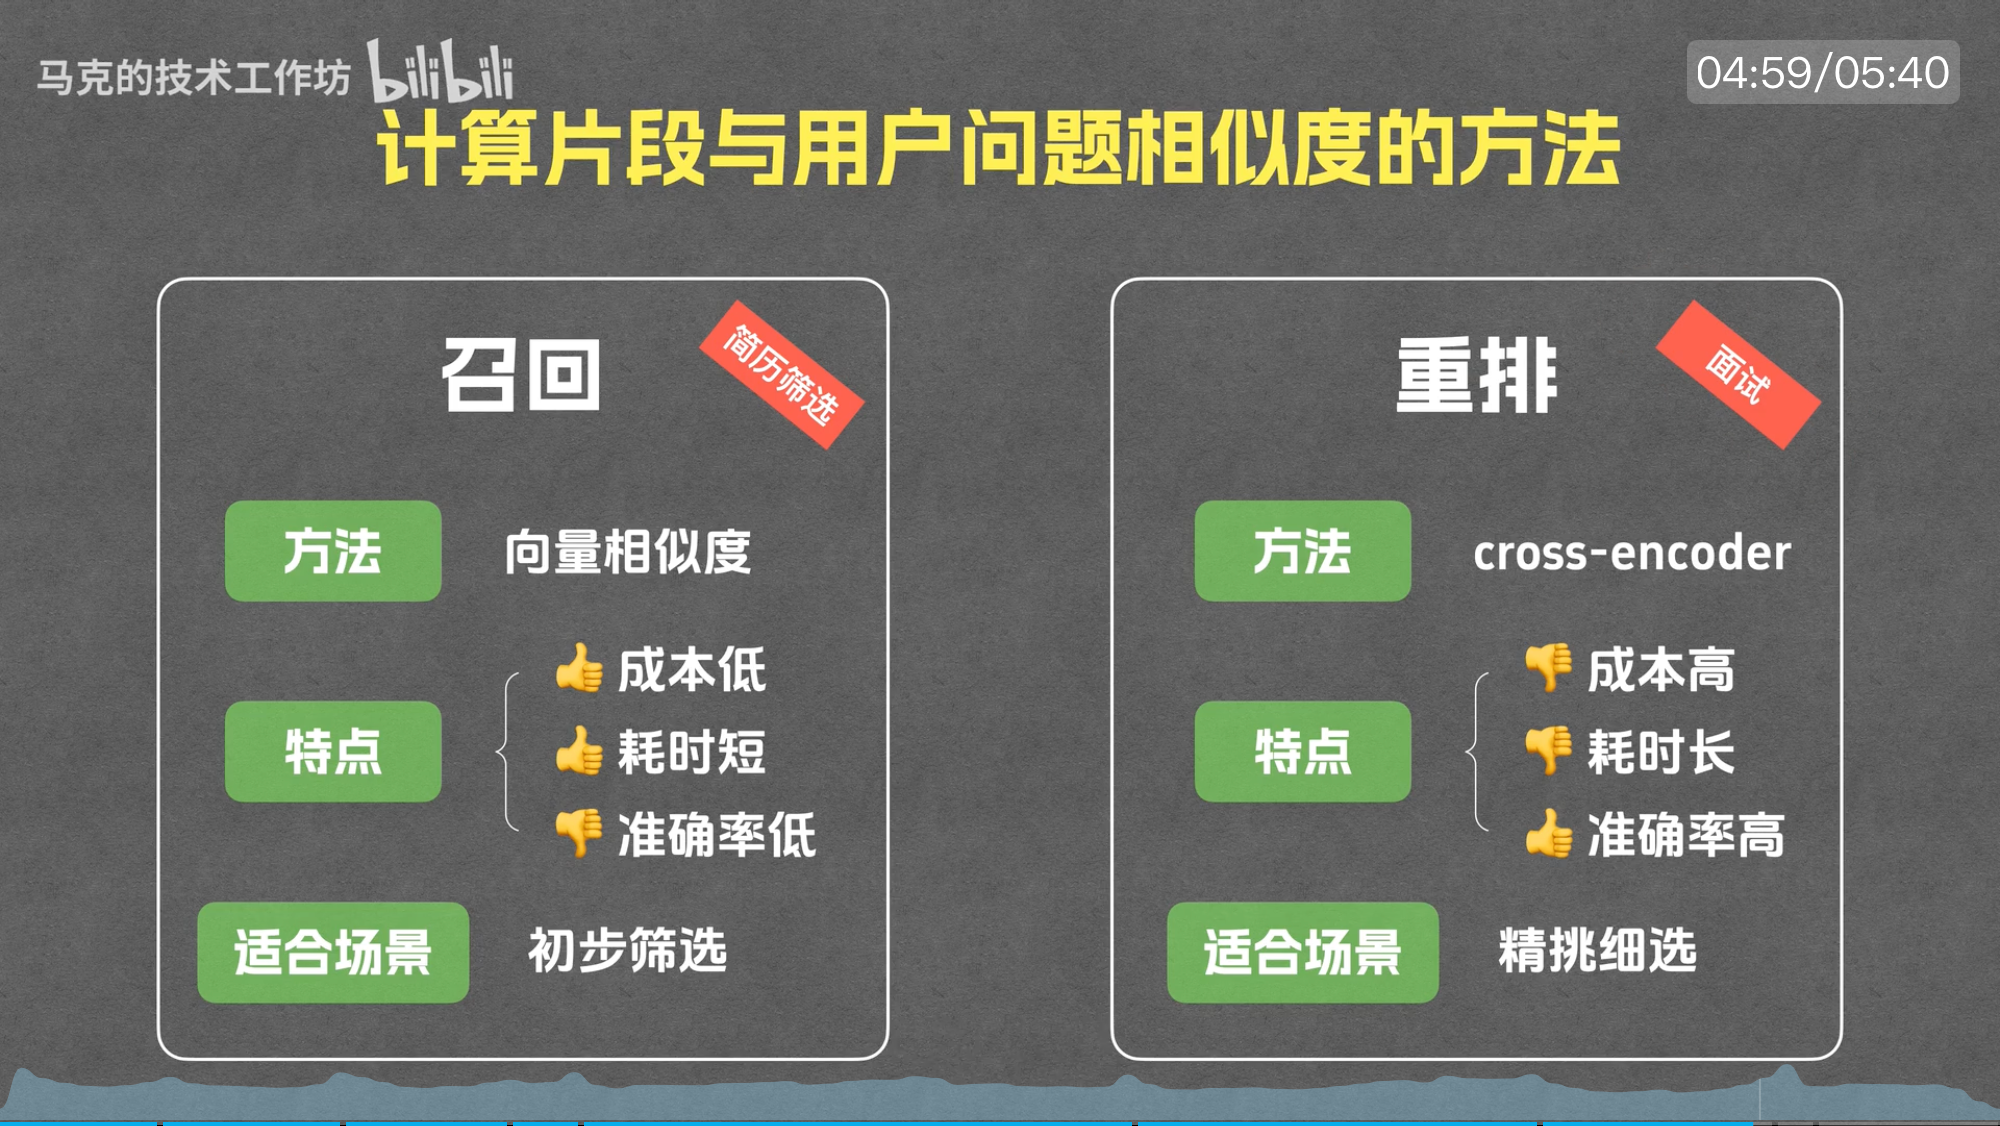
重排:从召回的结果中再继续挑选更相似的作为重排的结果
直接召回当然是可以的,但是效果没有召回+重排效果好,这两个阶段使用的文本相似度逻辑不同
对比一下:
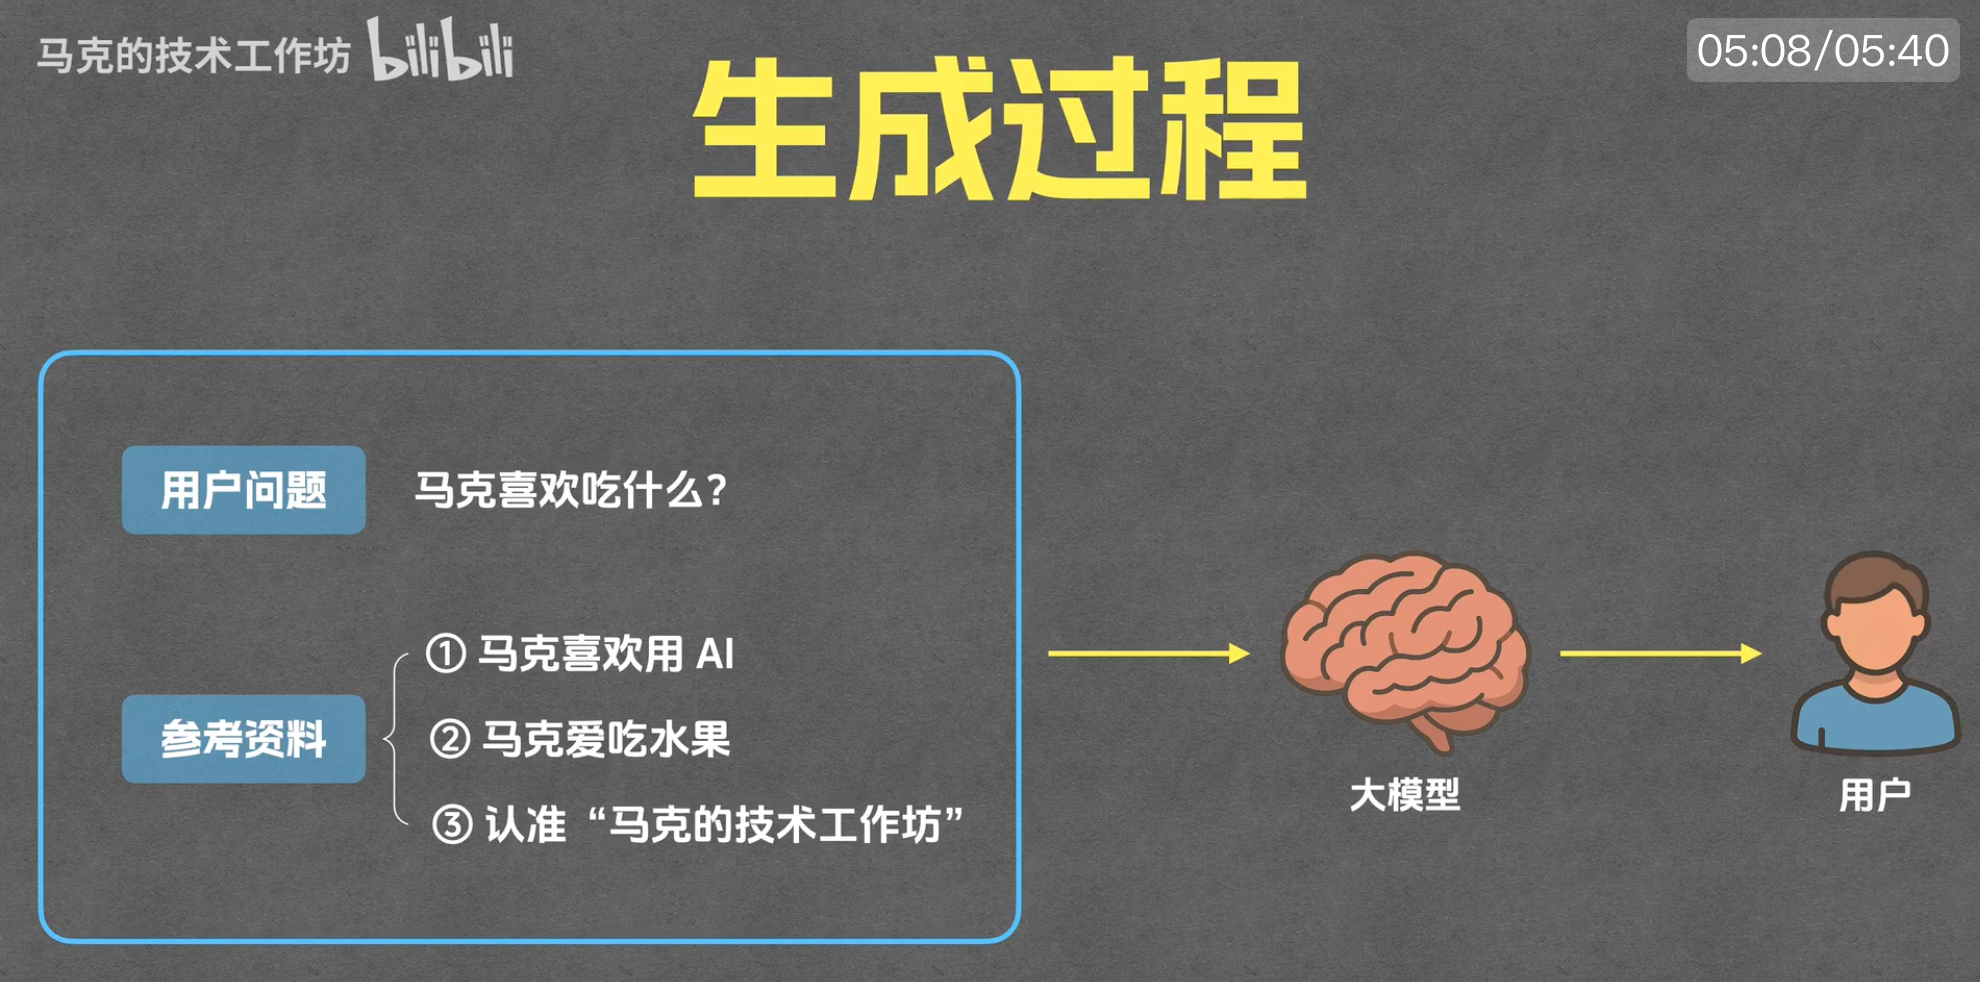
生成:即生成答案
总体流程:
使用 Python 构建 RAG:
使用Python构建RAG系统 —— 用代码还原 RAG系统的每个细节_哔哩哔哩_bilibili
OpenAI RAG
OpenAI 的 RAG 范例,无需向量化_哔哩哔哩_bilibili
先抽取相关内容,再根据内容回答问题的方式就是 RAG
不同实现方式「抽取」的方式也不同
- 传统 RAG:向量化
- OpenAI RAG:无需向量化
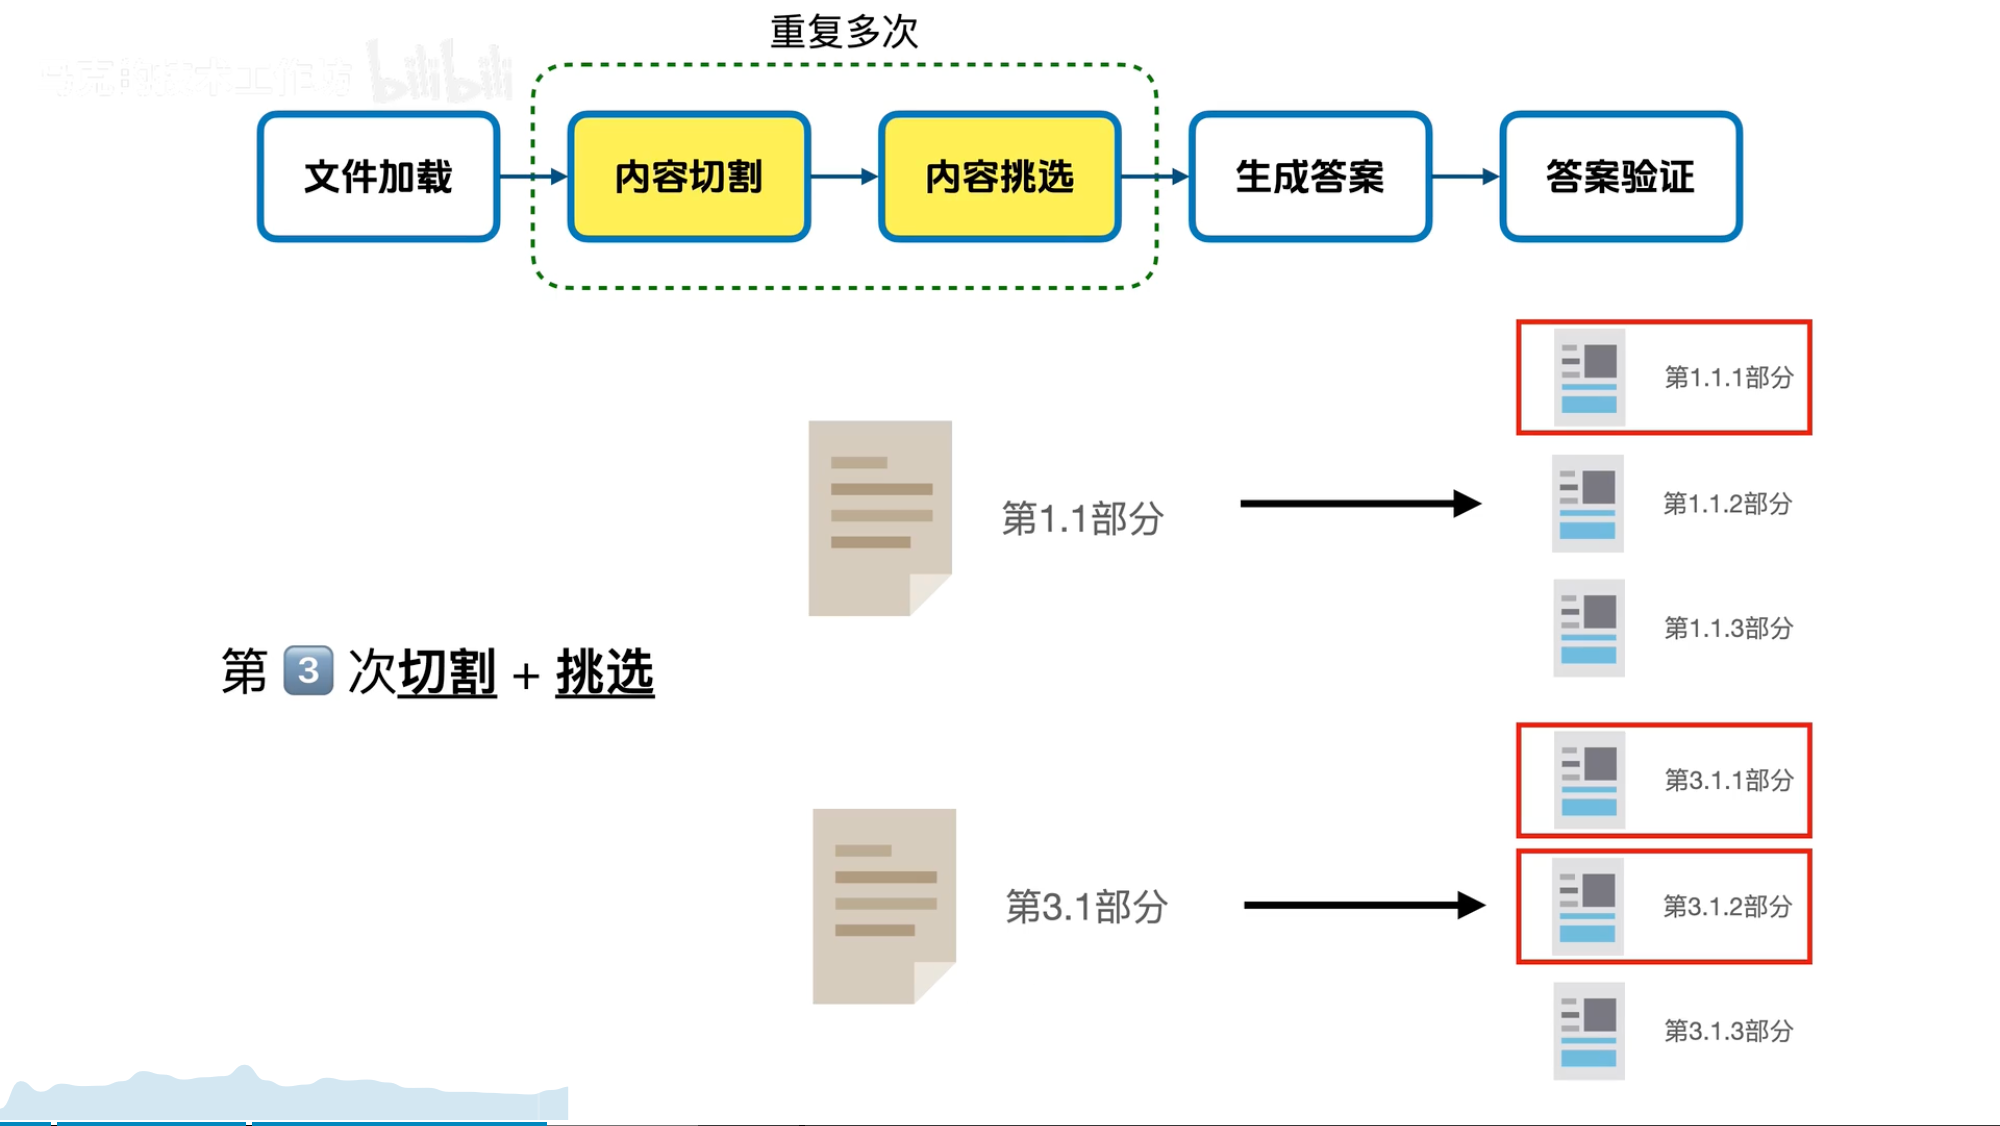
将内容切割为若干份,然后挑选,这样的流程可能需要执行几次,(为什么要这样干呢)
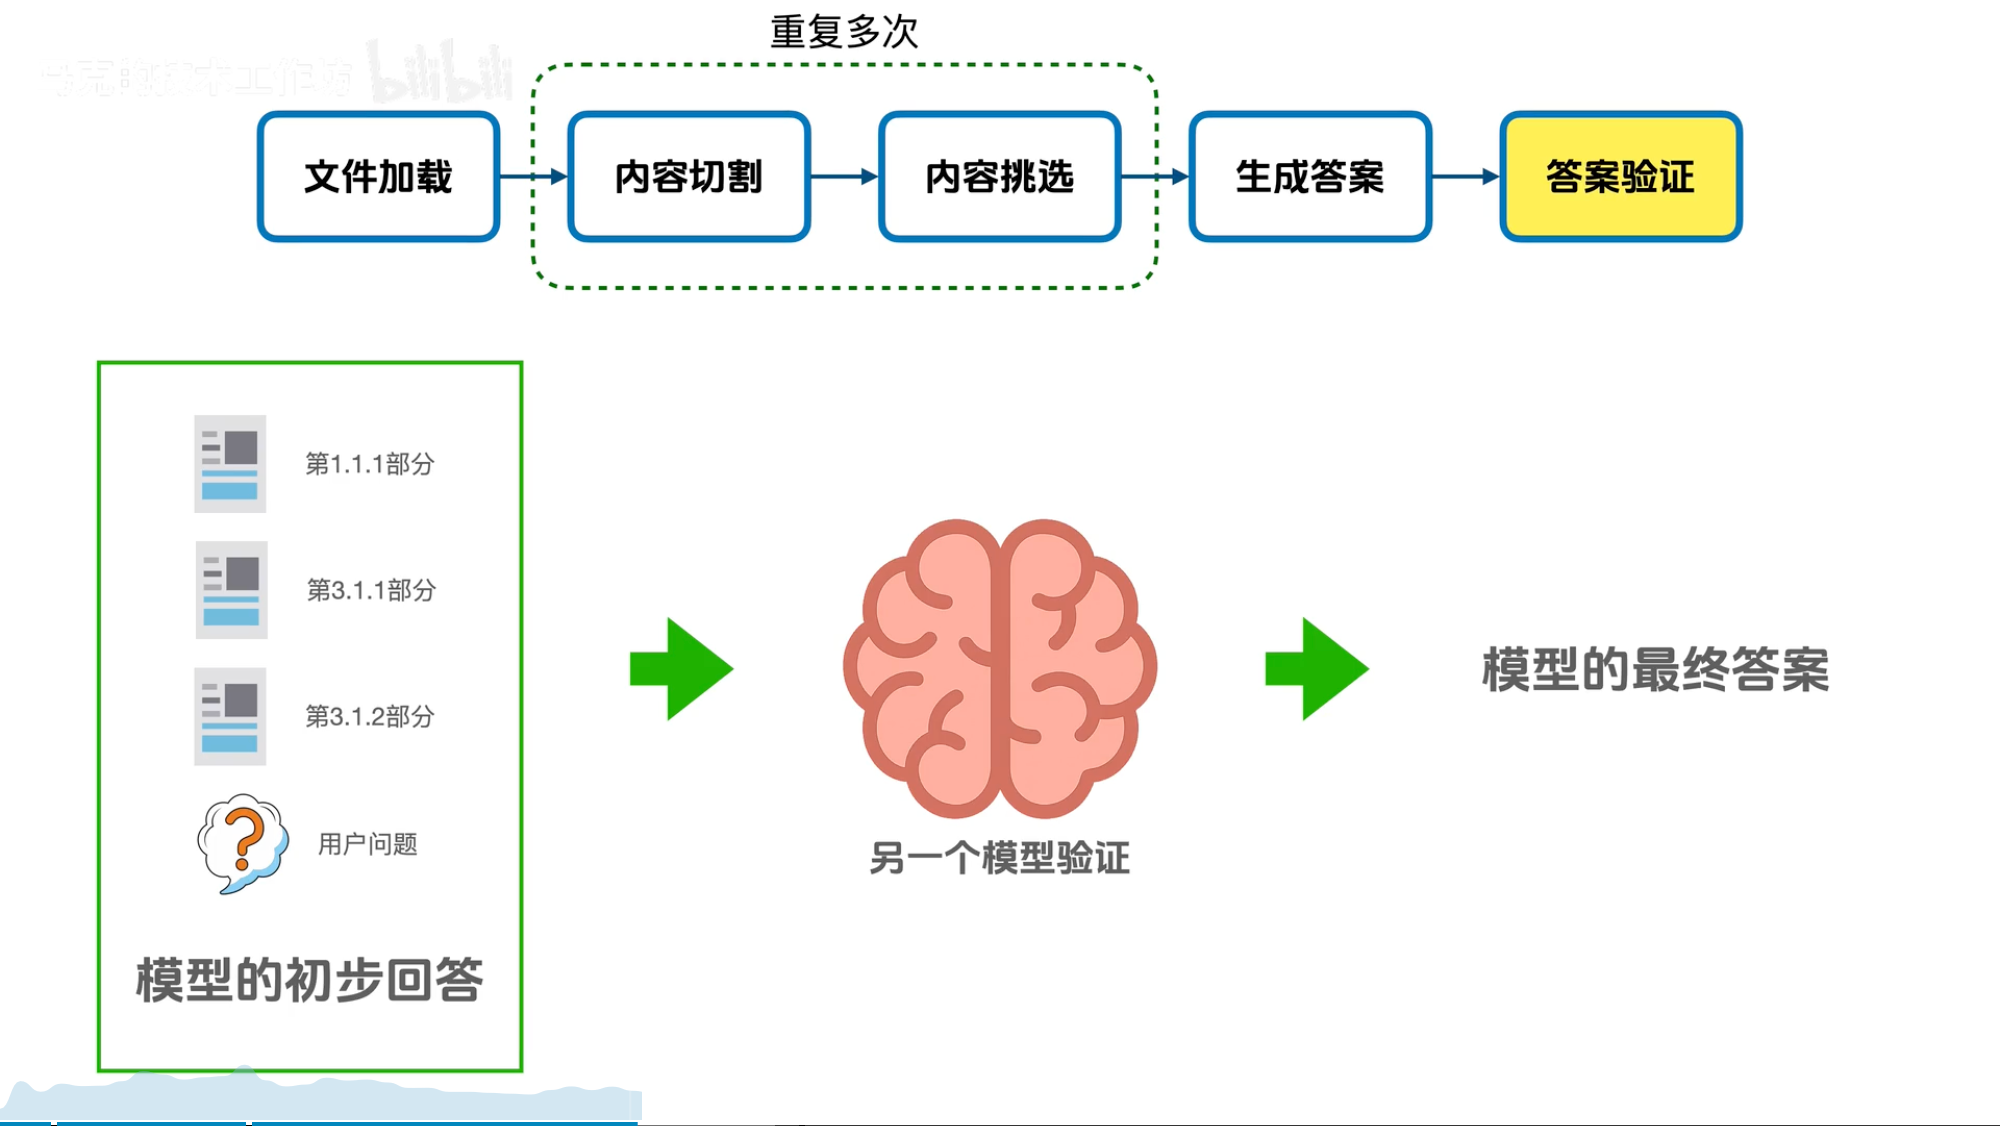
然后生成初步的答案经过挑选作为最后的答案
这里 openai 似乎只读 920 页内容,后面的内容不关心
感觉有些何意味的感觉,总之就是了解一下,不用过于关心了
这种方式虽然不需要向量化,但是花费会很高
(属于 Agentic RAG?)
RAG 实战-LLM-GEN
视频链接:大模型RAG企业项目实战:手把手带你搭建一套完整的RAG系统,原理讲解+代码解析,草履虫都能学明白!...
这是一个系统性的 RAG 教学课程,从零开始讲清楚 RAG 的完整流程、底层原理和实战技巧。
核心流程:RAG 两大步骤
离线阶段(系统上线前完成)
文档 → 加载 → 切分(chunk) → 向量化(embedding) → 存入向量数据库
- 文档加载 — 读取 PDF 等文档,提取文本
- 文档切分 — 按段落或按固定长度+交叠(overlap)切分,确保语义完整
- 向量化 — 使用 embedding 模型(如 OpenAI
text-embedding-ada-002或开源的 BGE)将文本转为向量 - 存入向量数据库 — 如 ChromaDB、Milvus、Pinecone 等
在线阶段(用户提问时)
用户 query → 向量化 → 检索向量数据库 → 召回相关片段 → 拼入 prompt → 调大模型 → 生成回答
关键知识点
1. 为什么需要 RAG?
- 大模型的知识有截止日期,不知道实时信息
- 大模型不知道你的私有/垂直领域知识
- 本质是开卷考试:让模型先翻书(检索),再看书回答
2. 什么是向量(Embedding)?
- 一段文本被映射到 N 维空间中的一个点(坐标数组)
- 意思相近的文本在空间中距离近,意思不相关的距离远
- OpenAI 的 ada-002 模型输出 1536 维向量
- 通过 cosine 距离(越大越相似,范围 0~1)或 欧式距离(越小越相似)衡量相似度
3. 向量数据库 vs 关键字检索
- 关键字检索(ES):精确匹配字面,换同义词就搜不到
- 向量检索:语义匹配,"国际争端" 能匹配到 "苏丹富尔地区大规模暴力" —— 即使没有一个字重叠
- 向量数据库解决的是快速检索的问题,不是生成向量的问题
4. 文档切分的坑与技巧
- PDF 很"脏",按空行切分可能把相关的内容切碎
- 交叠切分(overlap):相邻 chunk 有重叠部分,保证答案不跨段丢失
- chunk 大小需要根据实际情况调参,没有固定值
5. RAG 的优化技巧
| 技巧 | 说明 |
|---|---|
| 文档切分调优 | 调整 chunk 大小和 overlap 比率,确保答案不被切碎 |
| 检索后重排序(Rerank) | 先用向量检索多召回几条,再用 Cross-Encoder 模型重新排序,把最相关的排前面 |
| 更换 embedding 模型 | 开源可选 BGE、M3E 等;跨语言需求首选 OpenAI ada-002 |
| 本地私有部署 embedding | 使用 Sentence-Transformers 框架 + BGE 模型,数据不上传云端 |
6. 主流向量数据库对比
| 数据库 | 特点 |
|---|---|
| Pinecone | 付费云服务,省心,推荐给非私有化场景 |
| Milvus | 开源,功能完备,可极致调优,推荐 |
| ChromaDB | 轻量,适合学习和原型 |
| Elasticsearch / Redis | 老牌,也支持向量检索但性能不如专用库 |
7. 常见问题排查思路(重要!)
当 RAG 效果不好时,按以下三步拆解:
- 文档预处理 — 切出来的片段是否完整?答案有没有被切碎?
- 检索质量 — 检索回来的片段是否包含答案?是否排在前列?(检查 embedding 模型)
- 大模型能力 — 如果检索结果正确但回答不对,换大模型
永远不要笼统问"RAG 不好使怎么办",要学会拆解问题。